QQ扫一扫联系
不装 Python 环境,不用凑两张显卡,输入歌词加一句风格描述,输出一整首 32kHz 立体声 WAV。
用开源模型写歌,劝退人的通常是模型前面那一段:装依赖、下权重、改脚本、调端口。一圈折腾完,灵感已经凉了。MiniMax Music 3 的一键运行包进了 AIGCPanel 的模型市场(也支持本地导入),装好、启动,在工具面板里填上歌词和描述,歌就出来了。灵感来的时候,多一步折腾都是劝退。
歌词里写 [Verse]、[Chorus]、[Bridge],它按真实歌曲的结构铺编曲,前奏、主歌、副歌、尾奏一路走完,最长 300 秒不断档,主题、节奏和人声身份不跑偏。段落标签当结构提示,音乐描述当风格指令,两路输入同时进模型。
官方还配了一个 skill music-caption-rewriter,把一句「温暖华语民谣」扩写成 Global Metadata、Vocal Details、Arrangement 三段式描述;风格库里有 18 个风格家族、1000 份模板,模糊的形容能落到具体配器上。
想先听效果,官方 Live Demo 页收着几十首生成示例,仓库里也带了一段示例音频(assets/minimax_ttm.wav),不用装东西就能判断对不对味。README 写的是原生支持 up to five minutes、一次生成完整结构;这个服务的 config.json 里,时长上限 300 秒,下限 10 秒。
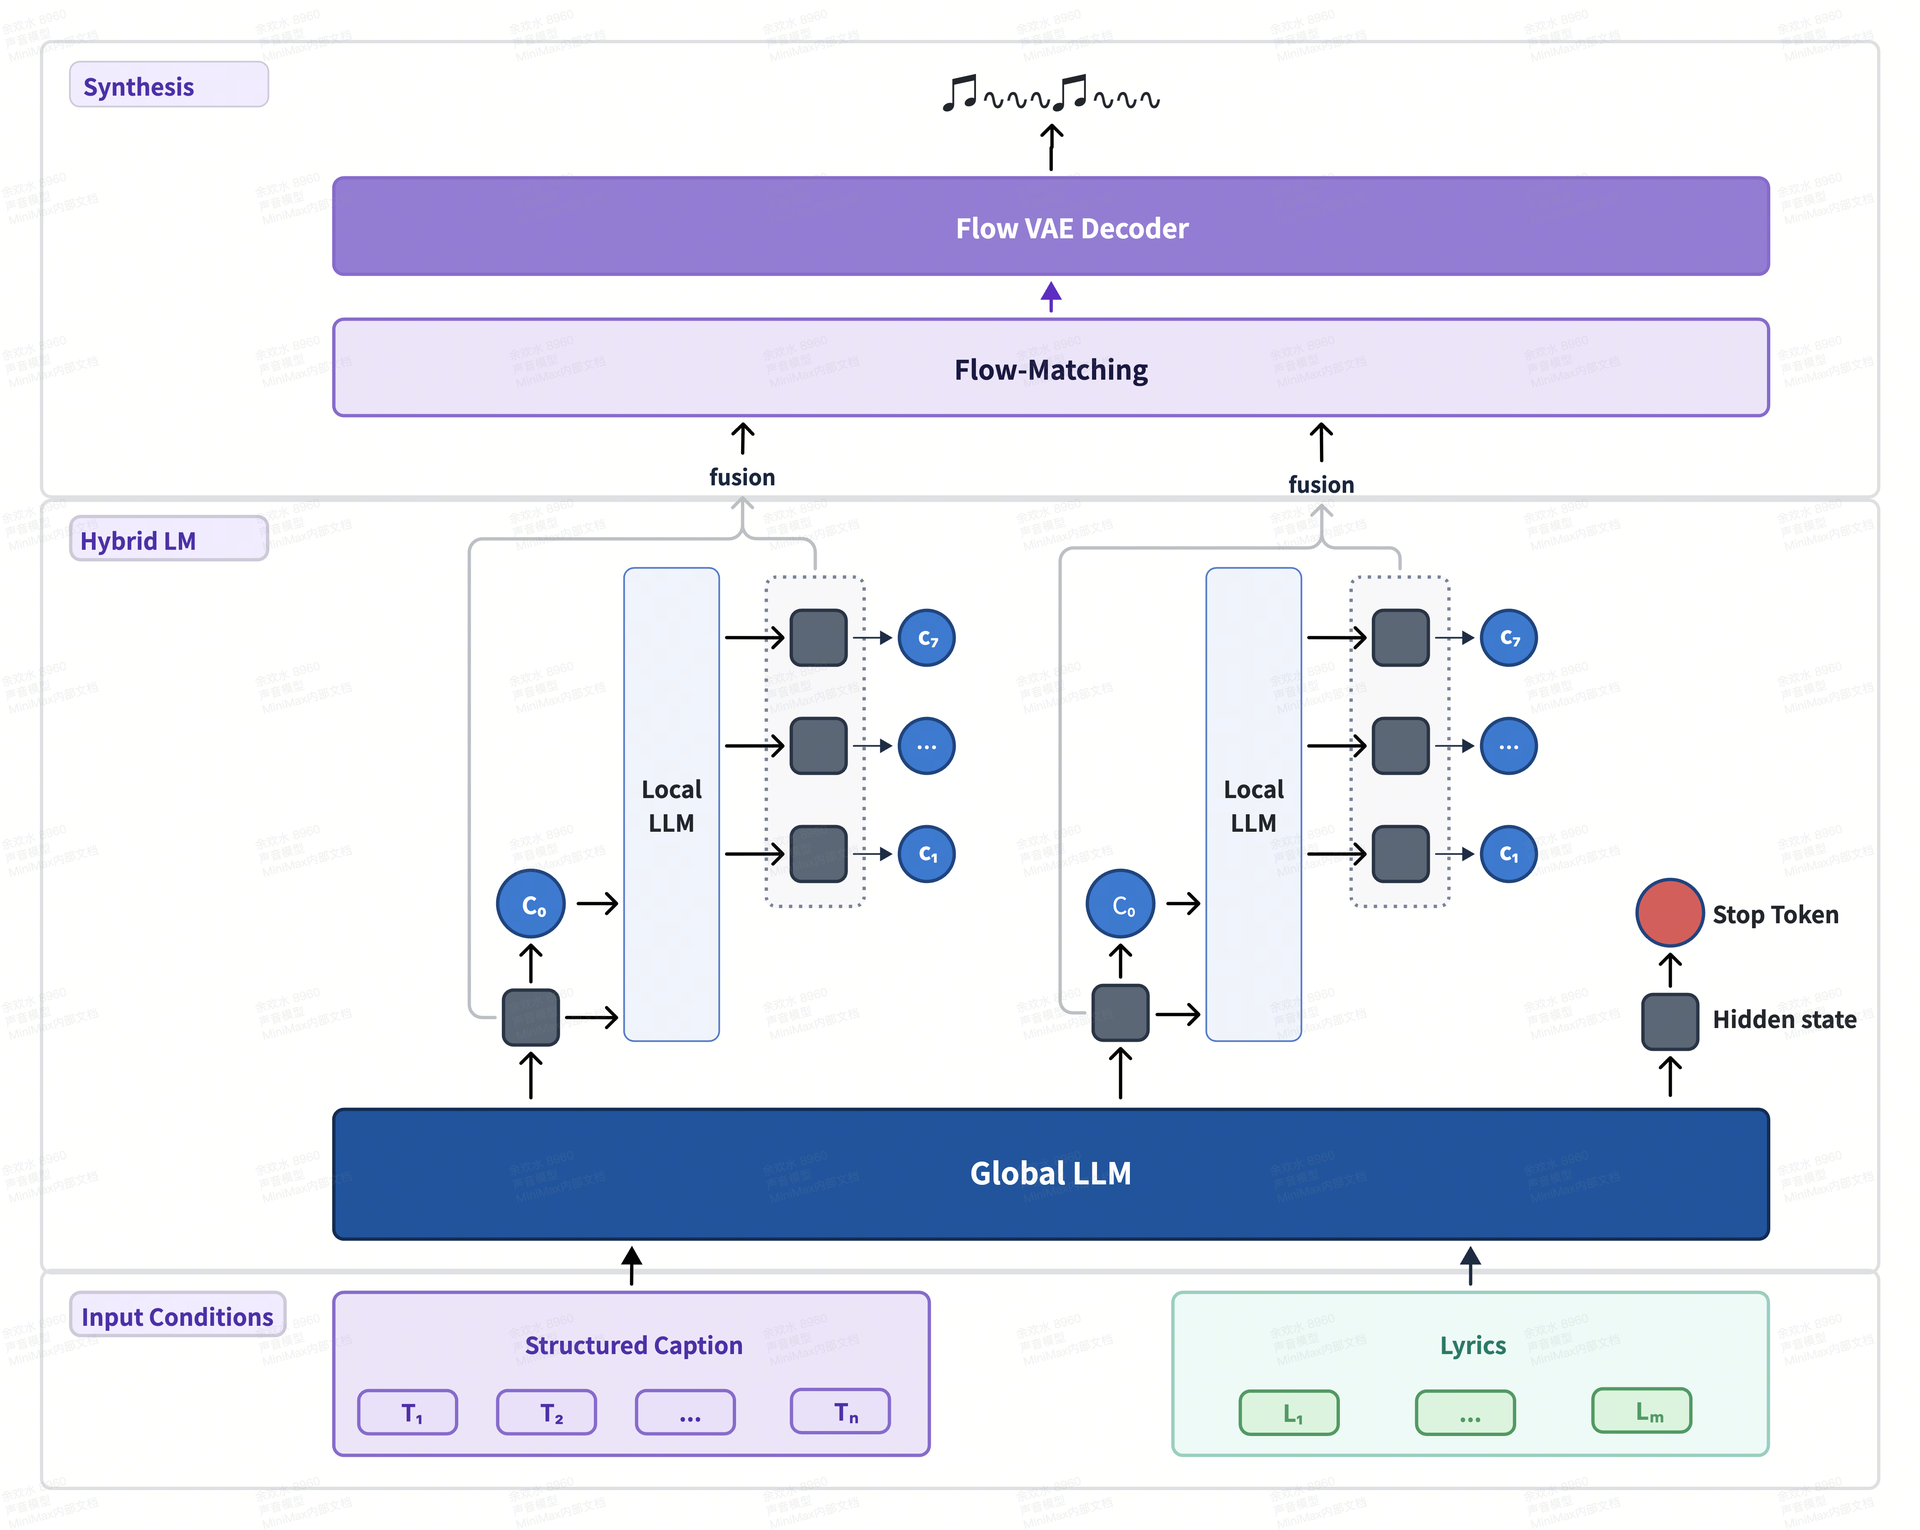
8B 负责想清楚整首歌怎么走,0.6B 负责把每一帧的呼吸补上。
所以咬字、乐器质感和段落之间的过渡更连续,长句子能一直撑住。两个模型都在自回归地预测音频码本:8B 的全局 LLM 管长程结构,从 Qwen3-8B 初始化;0.6B 的局部 LLM 管帧级细节。最后一步把两层隐状态直接融合,交给 Flow Matching 还原波形,不再只从离散码本解码。更细的规格(8 层 RVQ、第一层语义码本 16,384 项、32kHz 输出)在 README 的 Hybrid-LM 与连续隐状态合成两节。
这个服务把推理引擎换成了 audio.cpp 的 GGUF 量化运行时(Q4_0 组件组合),权重从 28.5GB 降到 8.4GB。官方标注的硬件是 GPU 8G+、内存 32G+,配置里给的峰值显存约 10G:8G 卡能跑,手上是 12G 以上的卡会更从容。
初始化脚本还做了两件小事:权重支持断点续传,下到一半断了能接着下,下完按官方 sha256 逐个校验;生成的音频会做一轮有效性检查,空文件或坏文件当场报错。前后对比记在 changelog 里。
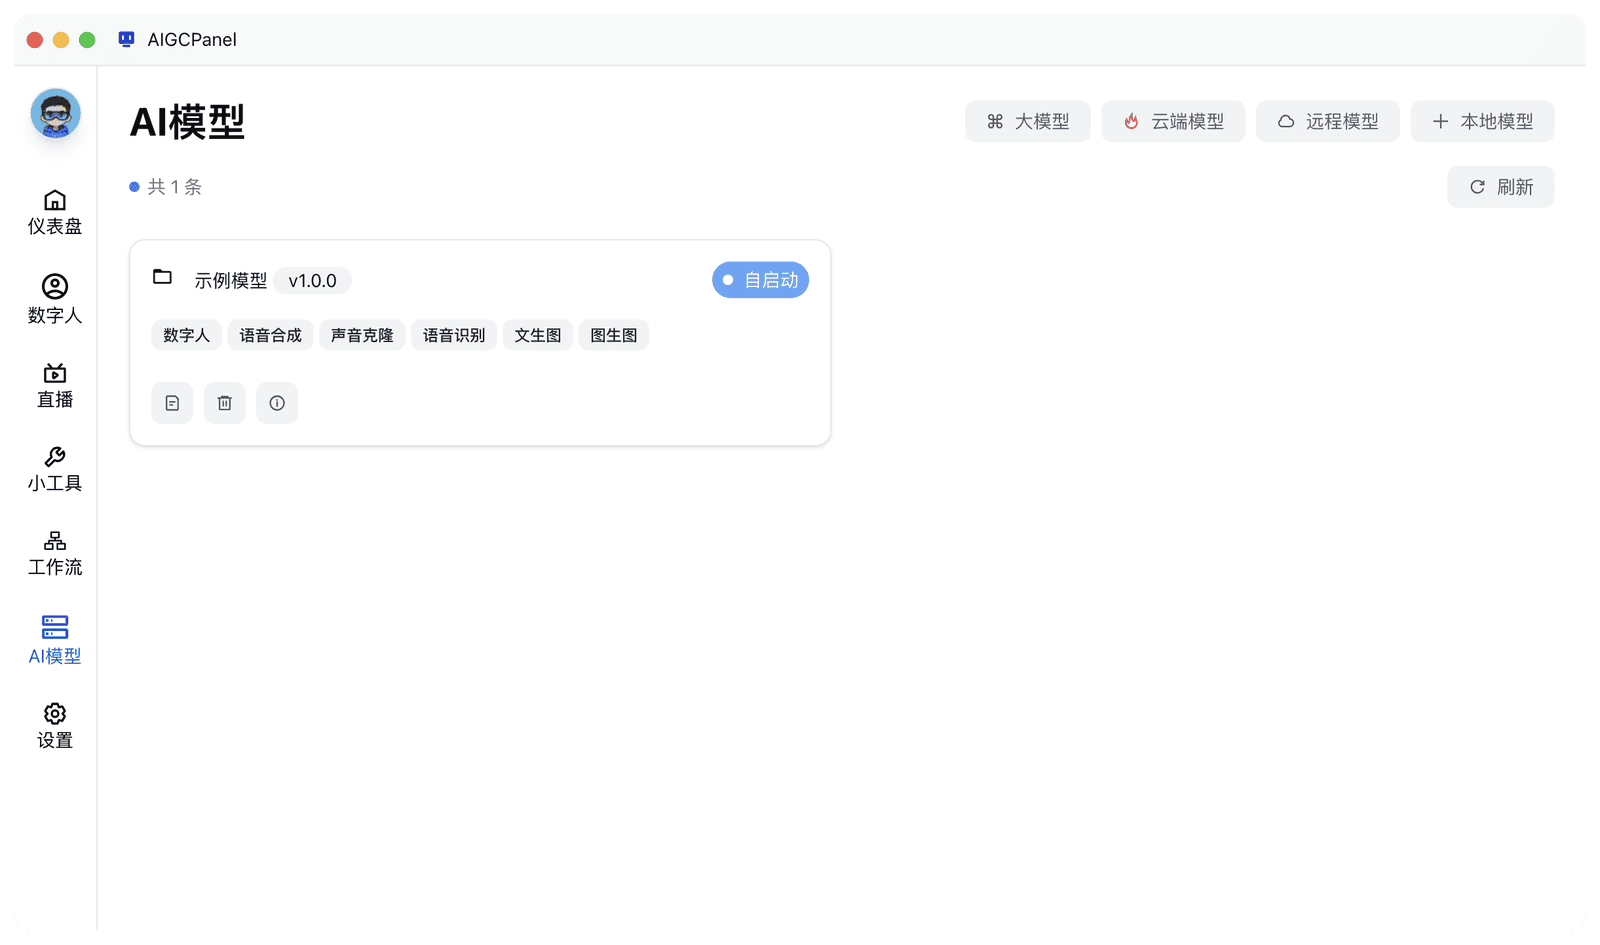
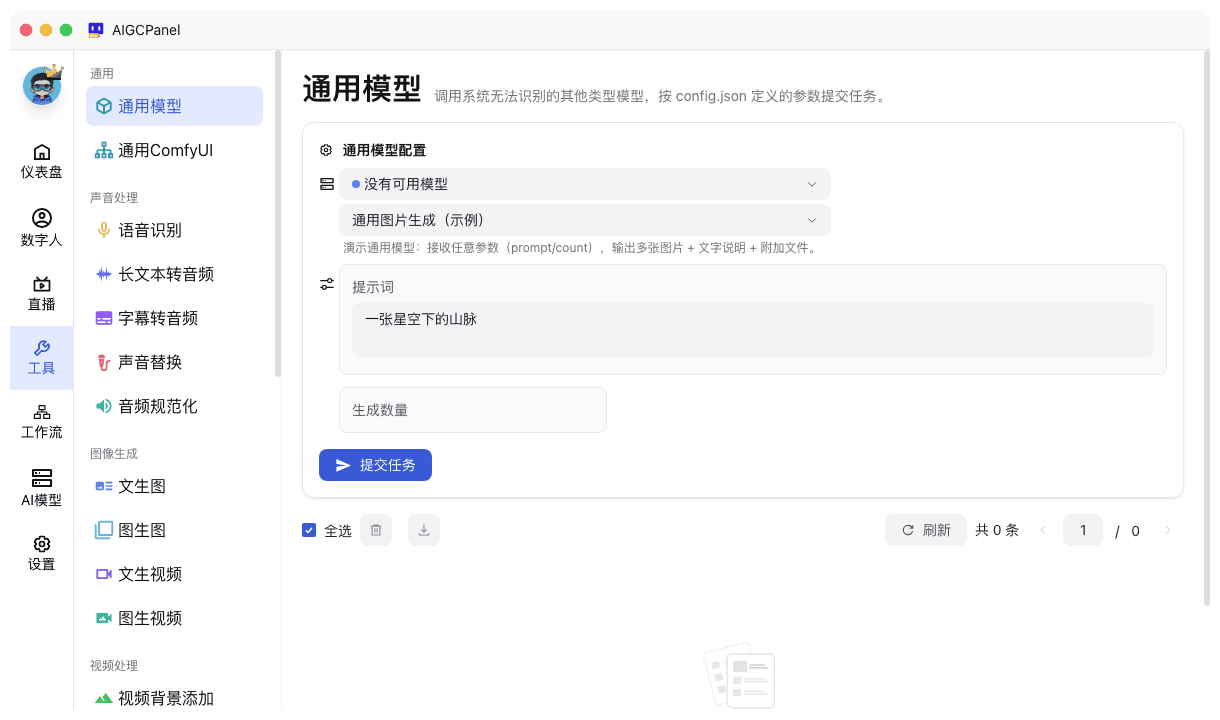
第一步,在「AI 模型」页装好 MiniMax Music 3(从模型市场下载,或直接添加本地模型),点启动,等状态变绿。第二步,左侧导航「工具」→「通用」分组 →「通用模型」。第三步,选声明了 general 能力的模型服务,功能选「AI 歌曲生成」,填歌词、音乐描述、时长、随机种子,提交任务,跑完在任务列表里下载 WAV。提交后要等一会儿,服务端给单次推理留的超时是一小时,时长设得越长等得越久。
能这么接进来,是因为模型的 config.json 用 general 数组声明了 musicGen 这个能力,参数表单和结果字段都由它定义,界面不用为每个模型单独写页面。换成别的开源音乐模型,操作路径也一样。
先装模型,再把备忘录里躺最久的那段词丢进去跑一版,出来的是一首能直接发出去的 demo。一个工具好不好,看它把「我有个想法」到「我有一首歌」缩到了几步。 你会先让它唱哪首?把歌名或一句歌词留在评论里,说不定下一版就是它。
本文技术参数来自 MiniMax Music 3 官方 README、本仓库的 config.json 与 changelog,以及 AIGCPanel 的「通用模型」「本地模型使用」两篇文档。