QQ扫一扫联系
350M 参数、1 步声学解码,还能把 [laugh] 写进文本里念出来。Resemble AI 这个英文 TTS 模型,轻得有点反常。
Resemble AI 开源的 Chatterbox Turbo 只有 350M 参数。为了压低延迟,官方把语音 token 到 mel 谱的声学解码器从 10 步蒸馏到 1 步,显存和算力一起省下来;它还支持 [laugh]、[chuckle]、[cough] 这类副语言标签,写在文本里就能念出来。参数只有大模型的零头,英文却说得有情绪。
做语音智能体的人,卡点通常不是「能不能合成」,而是合成得多快、吃多少显存。Chatterbox Turbo 的答案是:声学解码器只跑 1 步,模型规模压在 350M。主干 T3 仍是逐 token 自回归生成,延迟还是会随文本变长而增加,但整体开销比同级别模型低不少。
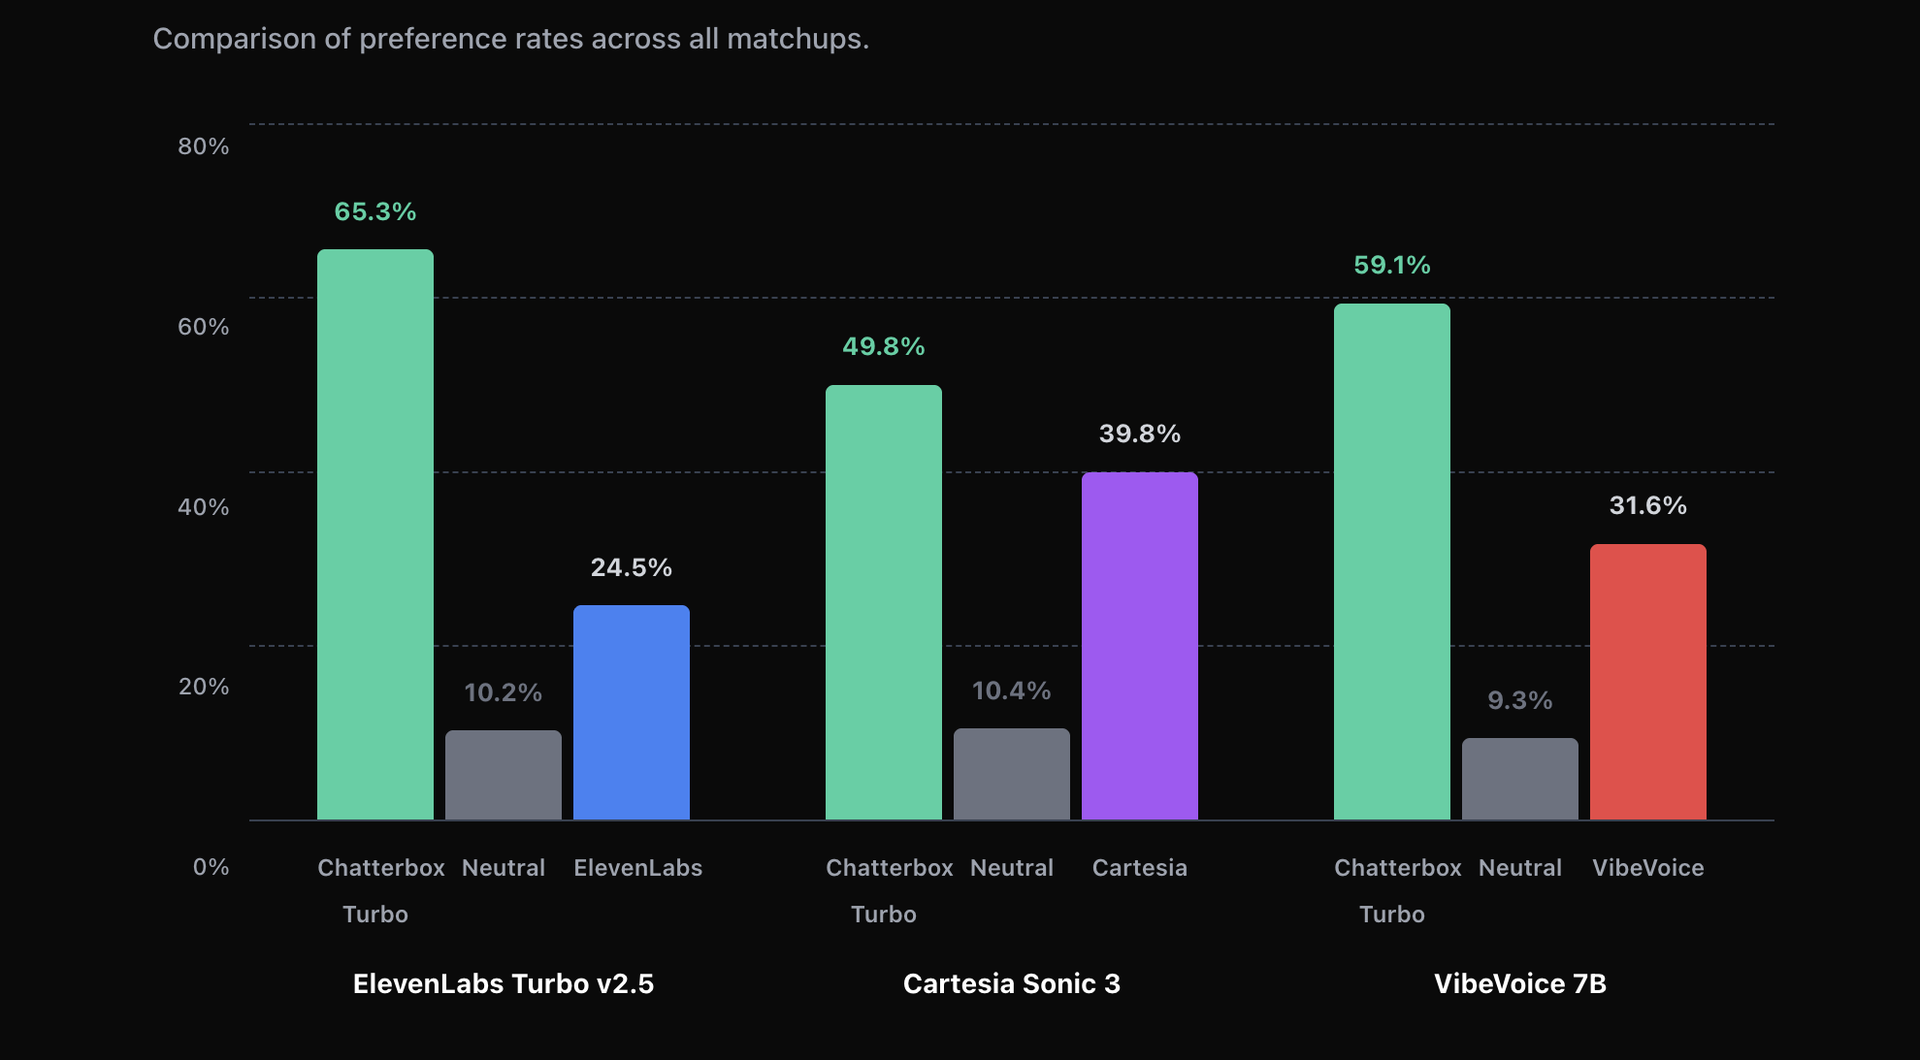
它也不是只跑分好看。官方用 Podonos 做了一套可复现的主观听感评测,分别与 ElevenLabs Turbo v2.5、Cartesia Sonic 3、VibeVoice 7B 做了两两对比,报告公开可查(评测报告)。模型与代码在 GitHub 开源,官方也放了在线试听。
多数 TTS 遇到笑声、叹气、清嗓子只能绕过去,Chatterbox Turbo 让这些标签直接成为文本的一部分。你写 [chuckle]、[cough]、[laugh](官方说明还有更多),它就在对应位置说出来,不用后期贴音效。官方示例那句客服开场白很典型:
Hi there, Sarah here from MochaFone calling you back [chuckle], have you got one minute to chat about the billing issue?
中间那个 [chuckle],就是「念稿」和「有人在说话」的差别。写的时候记得把标签放在词与词之间,别连着写,也别塞进英文标点里。
克隆同样是零样本:给一段 5-10 秒的清晰英文参考音频,它就用这个音色念新文本,不用训练、不用等。参考音频带什么口音,输出就是什么口音。
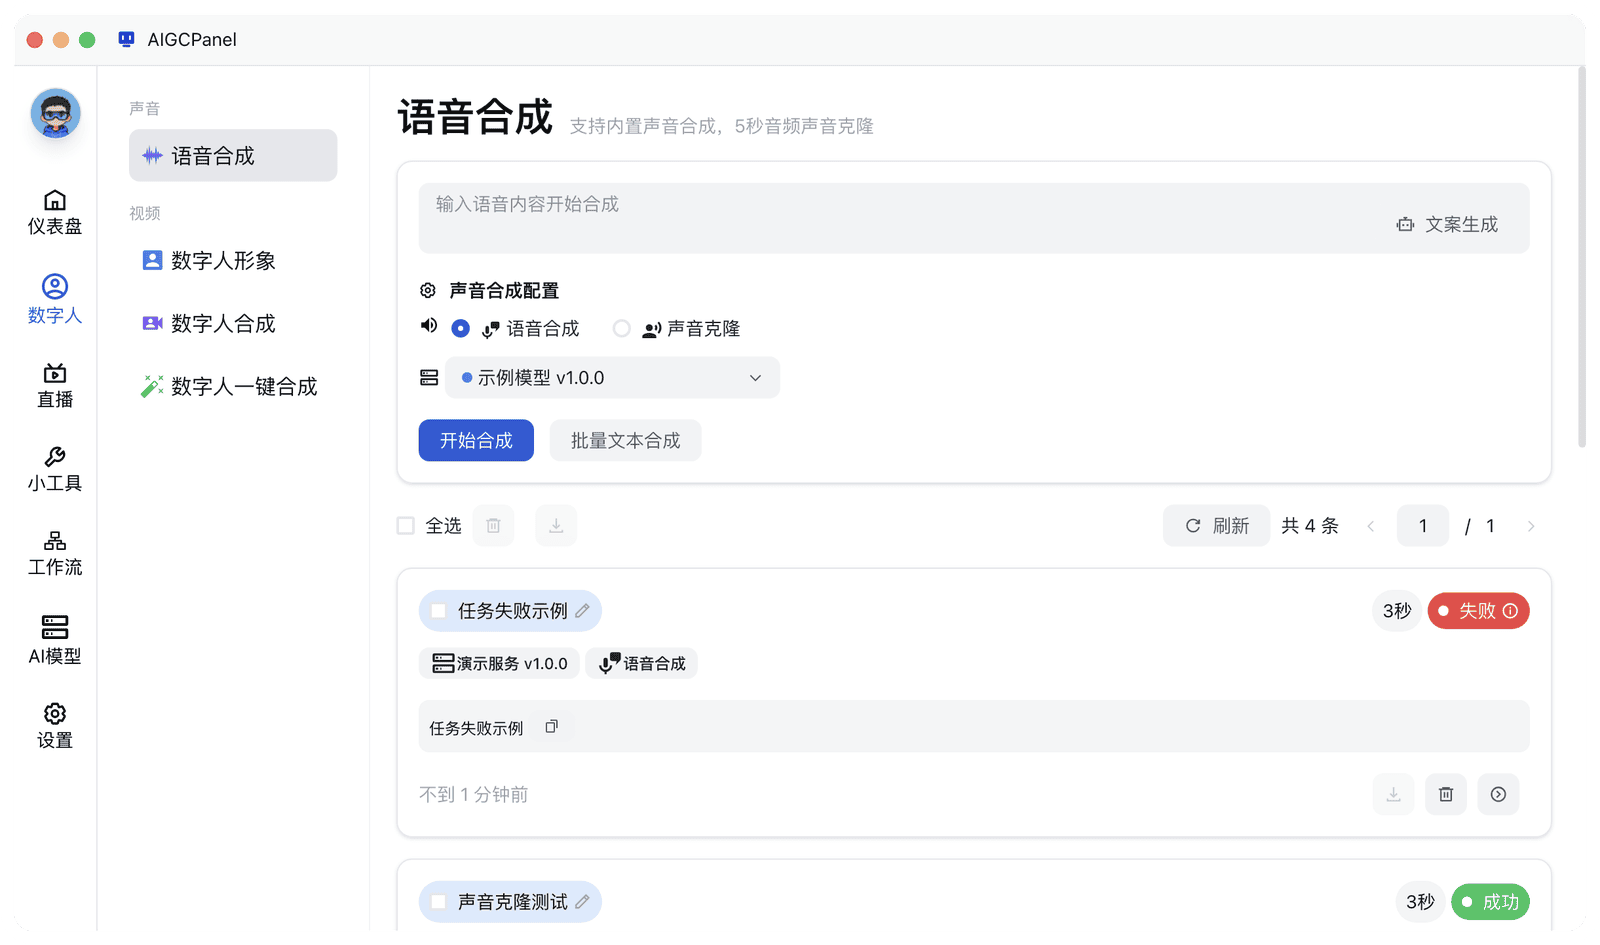
让它笑一下,比让它把字念对,更能说明模型的水平。
模型再好,卡在环境配置上也是白搭。AIGCPanel 是开源的 AI 数字人桌面应用,它把 Chatterbox Turbo 打包成了一键运行包:免费下载,GPU 4G+(推荐 8G+)、内存 8G+ 就能跑;权重约 2.8GB,装之前记得留出磁盘空间。
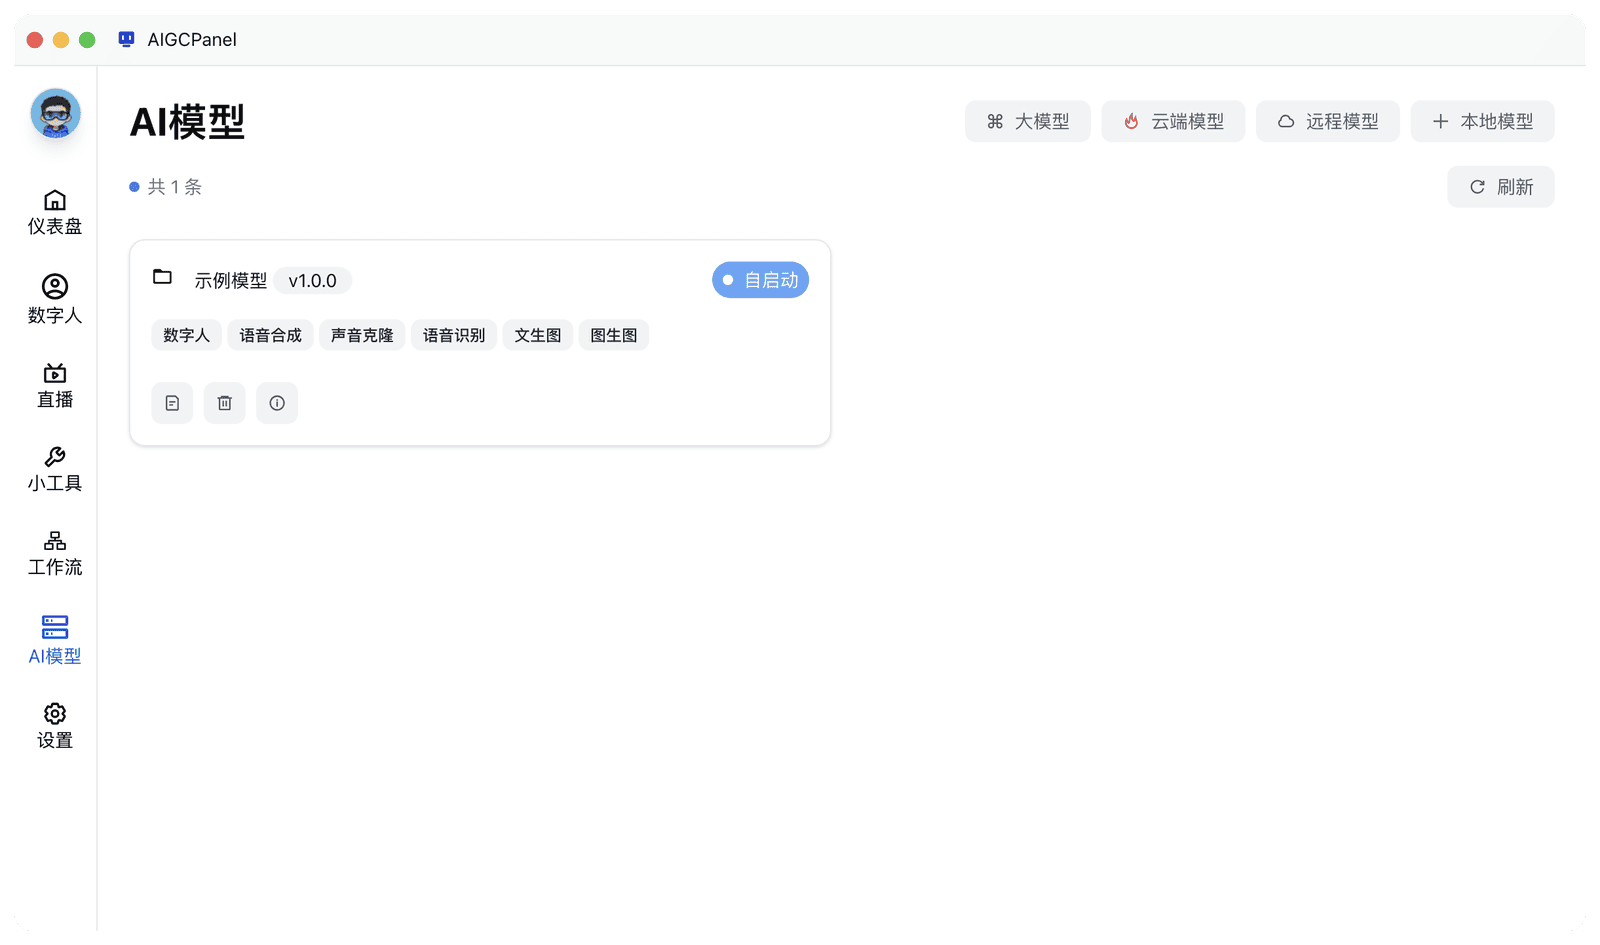
上手三步:
有一点要先说清:这个模型只认英文。中文文本、中文参考音频都会跑偏,中文内容建议先翻成英文。
可调参数只有三个:采样温度(默认 0.8)、Top-P(默认 0.95)、随机种子——同一个种子能复现同一段语音。音色不靠调参,不传参考音频就用内置默认音色,想换就用参考音频克隆。
输出是 24kHz 单声道 wav,可以直接丢进剪辑软件。推理全程在本机:有 N 卡走 CUDA,Mac 走 MPS,两者都没有才回退 CPU,慢一些,但跑得动。文本和音频都不出本机。
350M、1 步声学解码、原生副语言标签,凑在一个模型上。语音合成比的已经不只是「像不像」了。模型和代码都是 MIT 许可,商用自己评估就好。你能让它笑,它才算真的会说话。
如果你手上正好有需要笑一声、叹口气的英文文案,不妨下个 AIGCPanel 试试。你最想给哪句话加个 [laugh]?