QQ扫一扫联系
不用训练、不用准备数据集,一段 5 秒参考音频把整首歌换成另一种嗓音。
听歌的时候你大概想过:这首歌要是换成我的声音,会是什么味道?以前这个念头得从练声开始,现在可以直接交给模型。社区里这个开源模型叫 Seed-VC(论文 arXiv 2411.09943),主打零样本歌声转换。「零样本」的意思是它没见过你要模仿的那个人:你交一份唱好的音频,再给一段参考音色,剩下的它自己做。不用训练,不用整理数据集,一段参考音频就够了。
先把边界说清楚:它换的只是「嗓子」,不分离人声与伴奏,也不改编曲。想做出一首完整的翻唱,一般要先用工具(比如 UVR)把人声和伴奏分开,把干声丢进来转换,再合回伴奏上。它不是一颗从零到成品的魔法按钮。
换嗓这件事,只用一段参考音频
SeedVC 模型做的核心一件事是「保留内容、替换音色」:源音频里的歌词、旋律、节奏、换气位置全都留着,只有「这是谁在唱」被换掉。
它先把音频里的语音内容特征抽出来(编码器是 Whisper),再把原唱的音高走向作为 F0 条件交给扩散模型重建声学特征,最后用 44.1kHz 的 BigVGAN 声码器还原成音频。F0 就是一条音高曲线,唱到哪个音全写在上面,这也是它保得住旋律的原因。
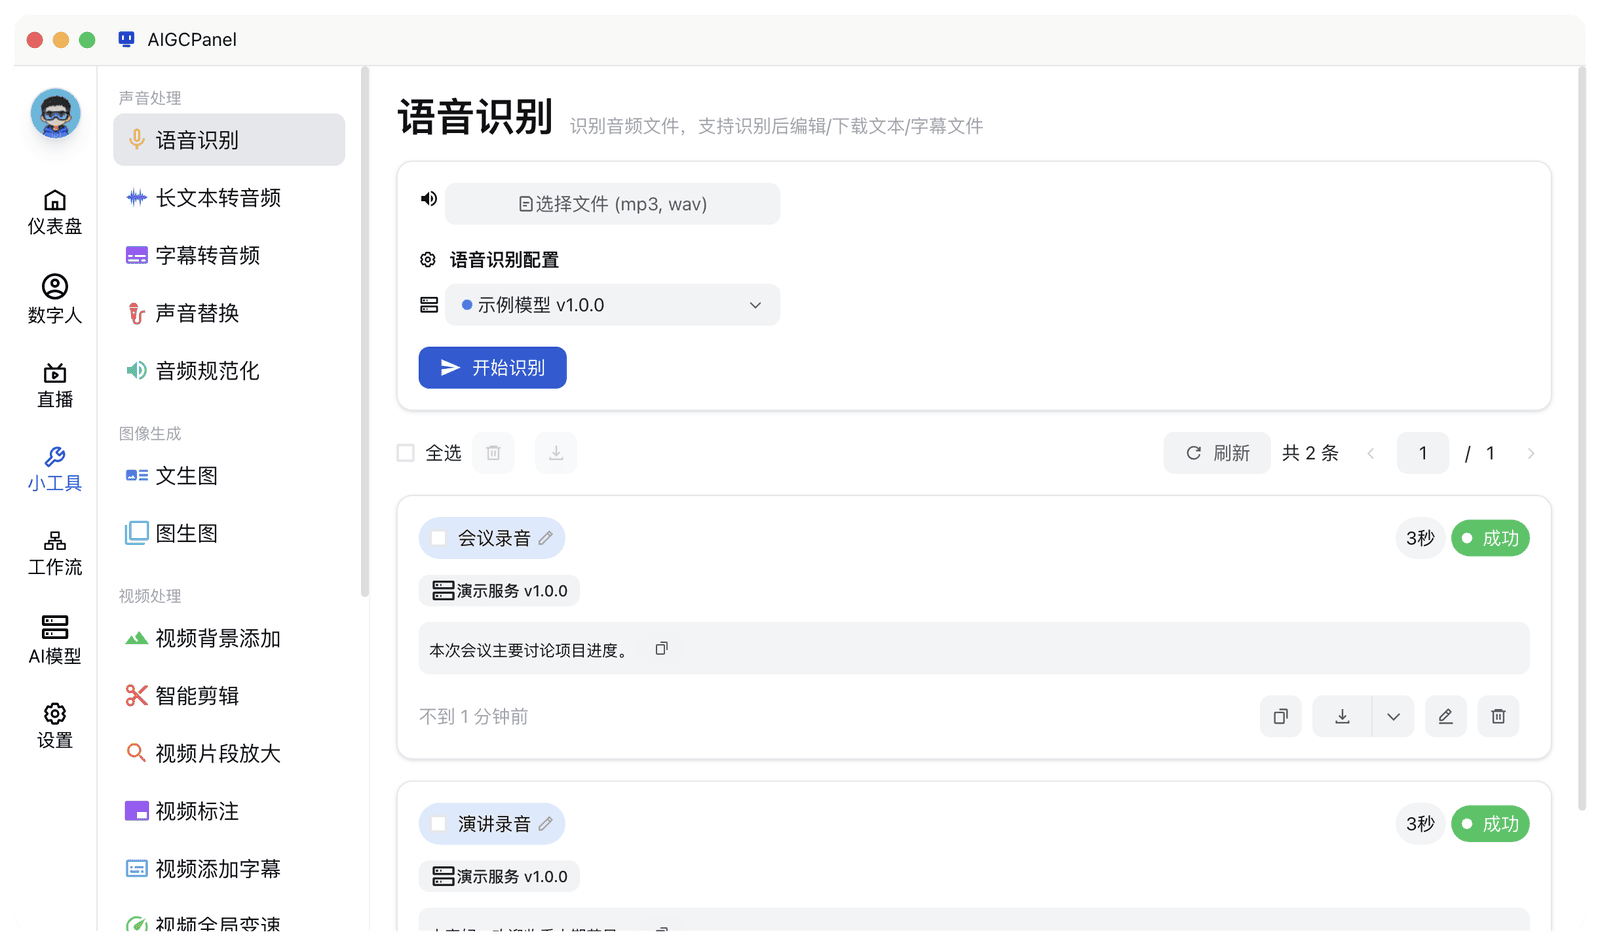
在 AIGCPanel 里,入口在「小工具 → 声音替换」,选中模型后跑的是「歌声转换」这个任务。
换一首翻唱,先动哪几个开关
任务表单里的参数不算少,但顺着「做一首翻唱」的顺序看就清楚了。
「启用 F0 音高条件」做唱歌必须开着,关掉的高音会塌成说话。「音高偏移(半音)」用来整体升降调;「自动 F0 调整」会把源音高对齐到参考音频的音高,换完发现和伴奏调性对不上,先把它关掉试试。再往后是「扩散步数」,默认 30,加到 30~50 音质更细腻,步数往下调出结果更快。最后的「随机种子」固定下来,同一首歌可以反复打磨到满意。
实时变声器是把你的声音即时改得不像你;SeedVC 模型是把整首歌的嗓子换成另一个人,唱法、气口、颤音还是原唱留下的。
在 AIGCPanel 里跑起来,三步
第一步,装好 AIGCPanel(官网 aigcpanel.com)。它是开源的桌面应用,Windows 与 macOS(Intel / Apple Silicon)都有安装包,GitHub 和 Gitee 上都能下。
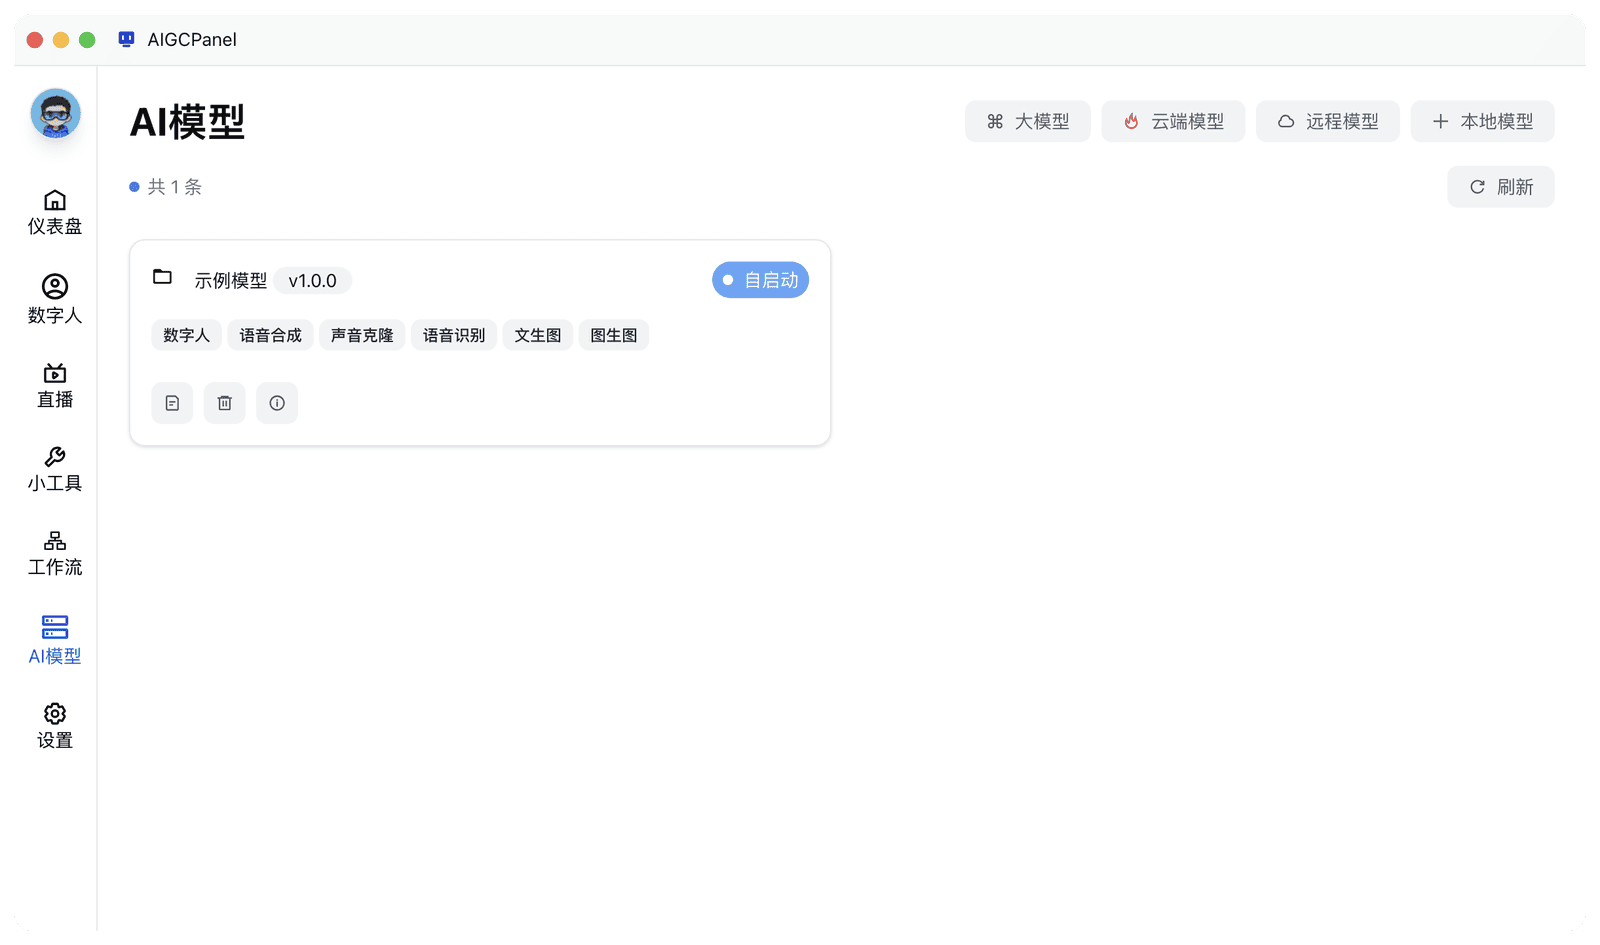
第二步,去模型市场把 Seed-VC 一键运行包下回来,在「AI 模型」页点「本地模型」导入。
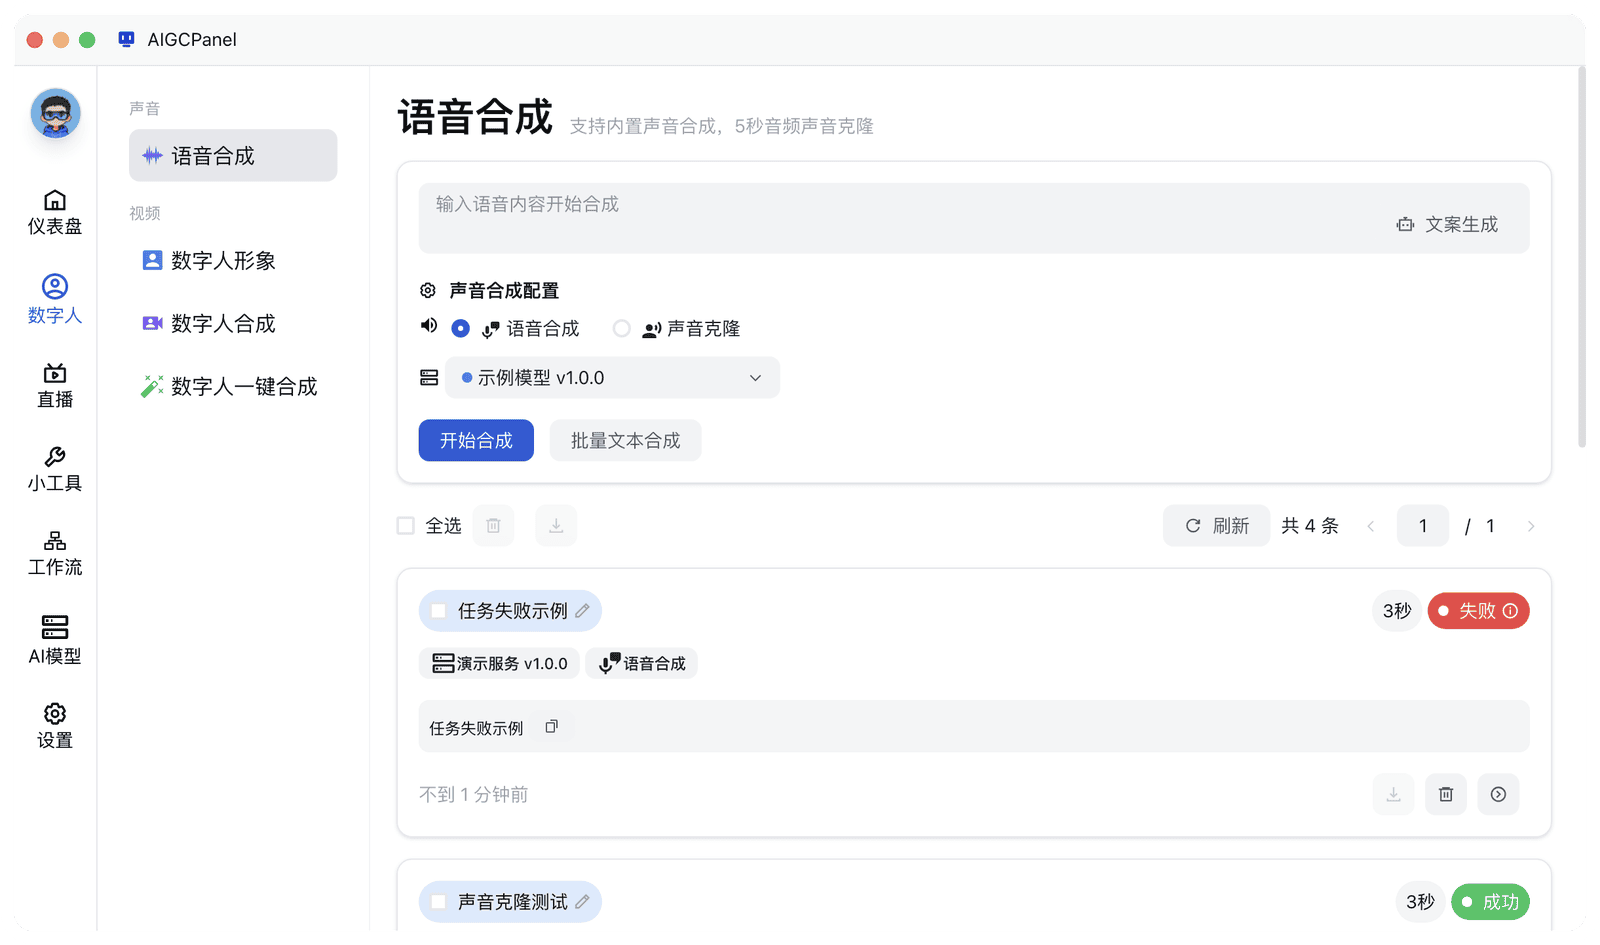
第三步,打开「小工具 → 声音替换」,选中刚导入的模型,填入源音频和参考音频,开始任务。
运行包是本地离线用的,模型下载完就不必再联网。任务开始时自动拉起模型,结束自动释放显存,参数和运行日志在界面上都看得见。显卡不够用,也可以切到云端模型服务。按官方说明,这个包建议 GPU 8G+、内存 16G+,目前发布的是 Windows 版。
除了唱歌,上游项目还有什么
SeedVC 模型出自开源项目 Seed-VC,同一套代码里还有几样东西,都需要自己部署源码才能用上。
实时变声是它的另一条主线:上游实测算法延迟约 300ms、设备侧约 100ms,配合 VAD 模型在没人说话时不会冒出杂音,开会、打游戏、直播都能接。V2 系列换了一套架构,引入 ASTRAL 量化的说话人解耦分词器,配上 CFM + AR 双模型,对源说话人的口音和情绪抑制得更干净,不只是换嗓子。想更像某个人,用 1~30 秒的干净音频微调就行,每位说话人最少 1 条语音、最低 100 步(T4 上约 2 分钟)出结果。
作者还公开了与 RVC、SoVITS 等模型的对比数据,歌声转换正是重点比较的场景。
其他要点
手上正好有一段清唱的话,不妨丢进去试试。换成别人的嗓子,或者让你的声音唱一遍那首喜欢的歌。有些音色,听一次就想自己拥有,而现在只需要一段参考音频。 试完记得回来在评论区说一声,你换的是哪首歌?