QQ扫一扫联系
1.3B 参数的开源数字人模型,单卡 4090 推理 96 FPS。AIGCPanel 把它打成了一个 Windows 一键运行包:装软件、导入包、选素材,然后等出片。
对口型模型的开源列表已经很长,多数人的体验却停在第一步:环境装不起来。Soul AI Lab 的 SoulX-FlashHead 是其中跑得最快的那一档,1.3B 参数,单卡 RTX 4090 上推理 96 FPS,还能一直往下生成不中断。
AIGCPanel 这次把它封成一键运行包,目前只有 Windows x86 版,需要 NVIDIA 显卡。主力机是 Mac 或 Linux 的,这篇可以先收藏着。
96 FPS 说的是推理速度,不是「能对着摄像头实时聊天」,这两件事之间差着一整套工程。
25 FPS 是这类说话视频的常规输出帧率,96 FPS 指的是推理速度:模型每秒能生成 96 帧画面,成片仍然是 25 FPS。中间的差额就是你要等的时间。
官方给的另一种用法更实在:同一张 4090 跑 3 路并发,每路仍有 25 FPS 以上,等于一台机器同时喂三个数字人。
压到这个速度的原因不复杂。骨干只有 1.3B 参数;沿 DMD 和 Self-Forcing 那条蒸馏路线,推理采样压到 4 步;Lite 变体的 VAE 换成了 LTX-Video 的轻量版。仓库致谢里把这些都点了名。
流式生成长视频有个通病:越往后误差越大,脸开始糊,慢慢不像本人。SoulX-FlashHead 的做法是在训练时拿真实视频当参考答案,不断把跑偏的结果往回拉,另外把音频特征缓存下来,避免长音频中途丢掉上下文。
效果能直接看样例:官方项目页公开的最长两段是 41 秒和 45 秒,全程没有明显漂移,也不需要分段拼接。再长就没有公开样例了,属于还没人验证过的区间。
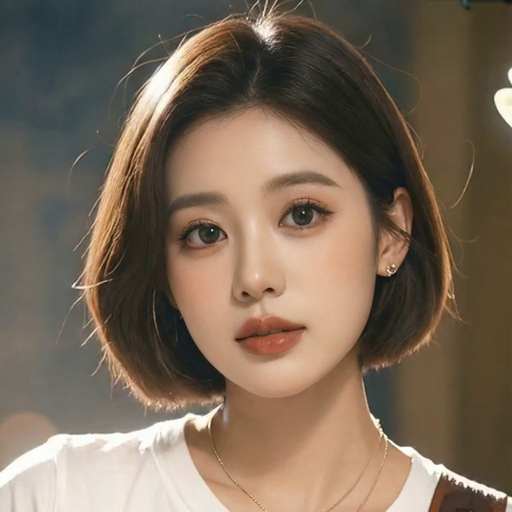
一张人像,一段音频,输出 512×512、25 FPS 的说话视频。
图片用正脸、单人、光线均匀的照片,官方示例素材就是一张 512 见方的人像。音频不用自己转码,WAV、MP3 直接传,采样率软件会处理。
要提醒一句:成片是 512 见方的方图。如果你在做 9:16 竖屏短视频,后面还得自己补一步。
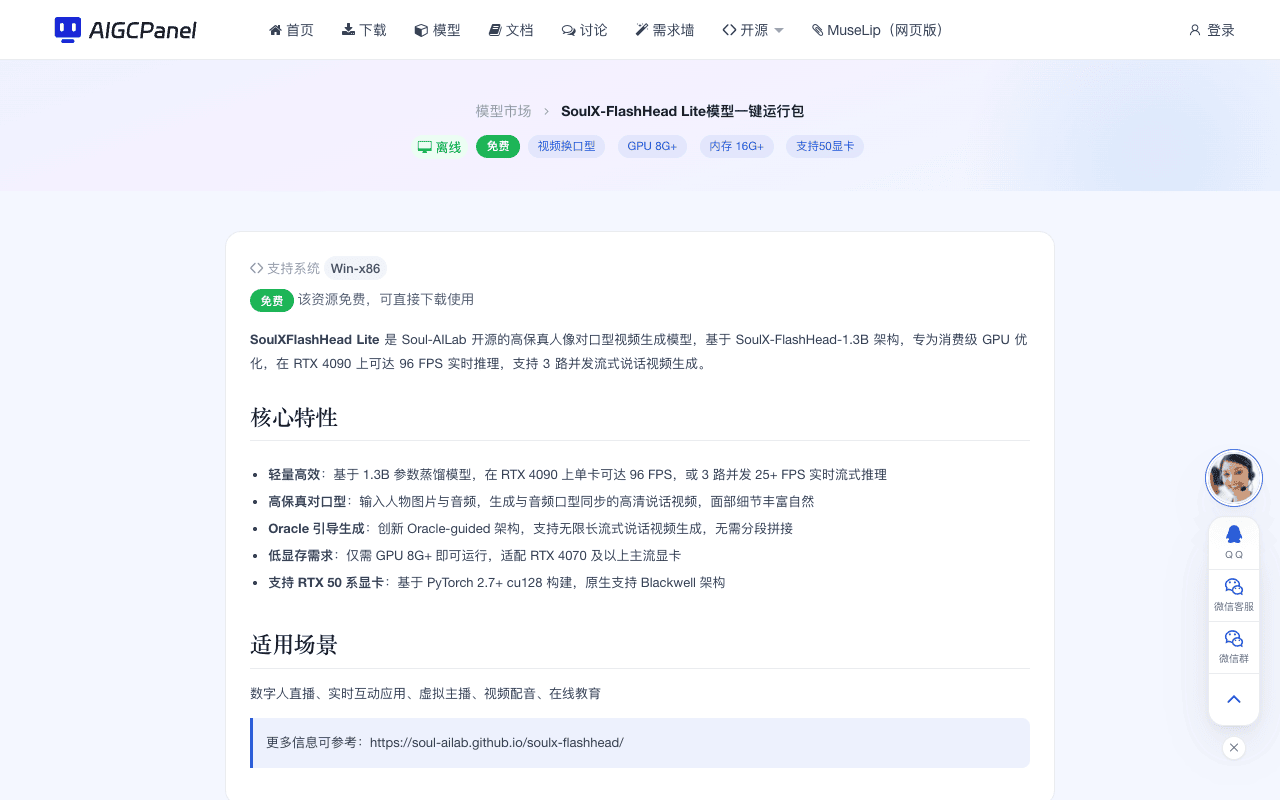
官方标注是显存 8G 起、内存 16G 起,推荐 RTX 4070 及以上。这两个不是一回事:8G 是能把模型加载起来的下限,4070 这一档(12G 显存)才是跑得舒服的配置。
本文出现的所有 FPS 都是 4090 的成绩。4070 及以下会明显慢,第一次用建议先拿 10 秒音频试,摸清自己机器的节奏再上长片。
它用 PyTorch 2.7 + cu128 构建,50 系显卡能原生跑。代价是驱动不能太旧:装之前先把 NVIDIA 驱动更新到较新版本,本地跑模型最常见的翻车就是「有显卡但识别不到」,根子基本都在驱动。
标称 96 FPS 的机器和你自己的机器之间,差的往往不是速度,是能不能把它加载起来。
一键包里内置的是 Lite,也就是 96 FPS 那个。官方还有画质更好的 Pro,代价是慢得多,4090 单卡 10.8 FPS,想实时得双 5090;Pretrained 版本还没放出来。
论文里附带了一个 782 小时的 VividHead 口播数据集,对想做微调的人是额外收获。代码库 Apache-2.0。
以前跑这类模型,先配 conda 环境,装 cu128 的 torch,再编 flash-attn。光 flash-attn 编译就能劝退一半人。AIGCPanel 干的事是把这些封成一个包:环境、权重、依赖都在里面。你要做的还是下载、解压、导入,只是比从 conda 开始省事得多。
装软件。官网下载页有 Windows、macOS、Linux,macOS 也可以一句 brew install --cask aigcpanel。这个模型包只发 Windows x86 版,所以真正要跑它还是得回到 Windows。
拿运行包。在模型市场下载 SoulX-FlashHead Lite 一键运行包,得到一个压缩文件,直接解压。路径里不要有中文和空格,官方建议放 D:\aigcpanel\models\ 这类纯英文目录。
导入并启动。进「模型」页,右上角「添加模型服务」→ 选择本地模型 → 选中刚才解压出来的那个文件夹,名称保持和下载时一致。导入后点启动,状态变成绿色「运行中」就能用了。

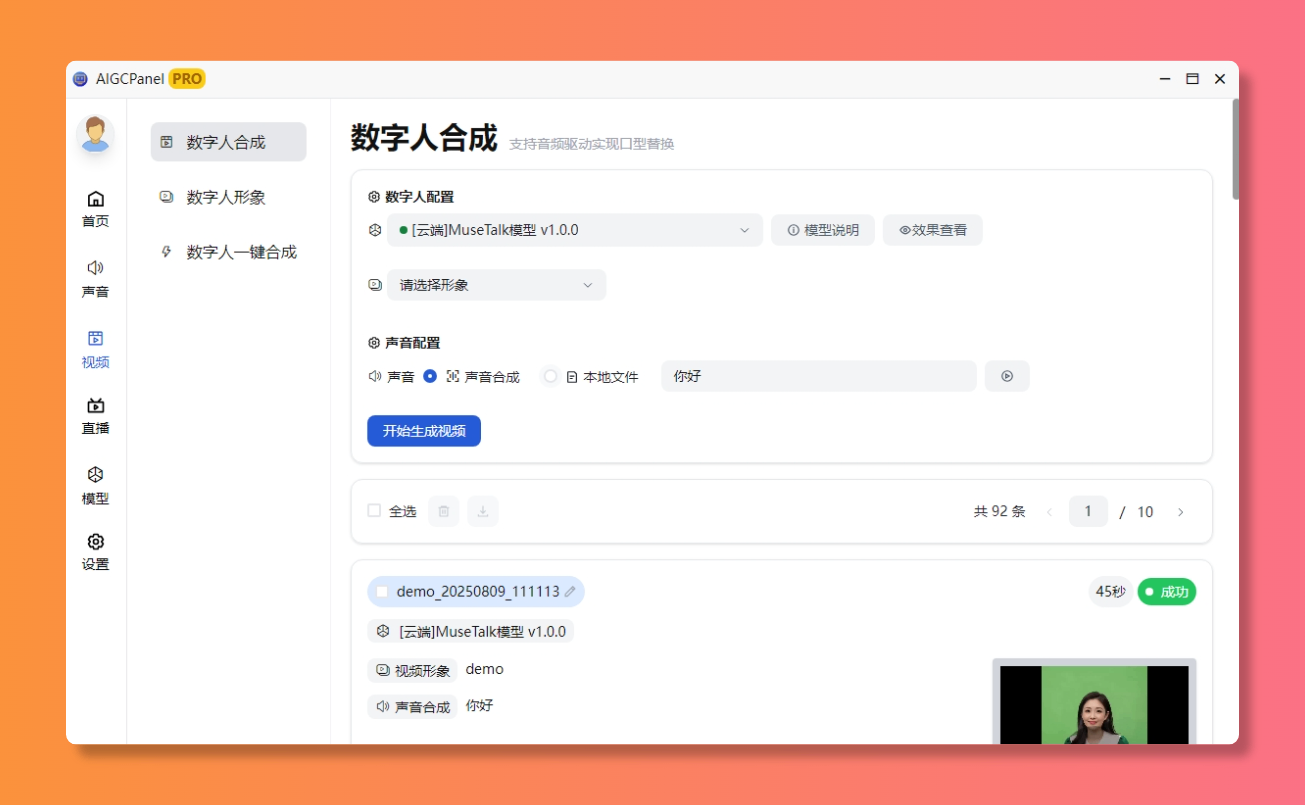
点完之后就是排队加推理。第一次任务要先把模型加载进显存,比后面的任务慢一截。跑完在任务列表里点开就能预览,也能直接下载 MP4。
用文字合成声音的话,得先在软件里装一个语音合成模型,否则音色列表是空的。只想快速验证效果,直接传一段录好的音频最省事。
如果你手上有张 8G 以上的 N 卡,想试试开源里跑得最快的那一档对口型模型,现在不用再从 conda 开始了。
跑完欢迎回来报个数:什么卡、多长的音频、等了多久、长片有没有崩。这些数字比任何标称 FPS 都更能帮下一个人决定要不要下这个包。
模型从来不缺,缺的是让它在你机器上真正跑起来的那一段路。