QQ扫一扫联系
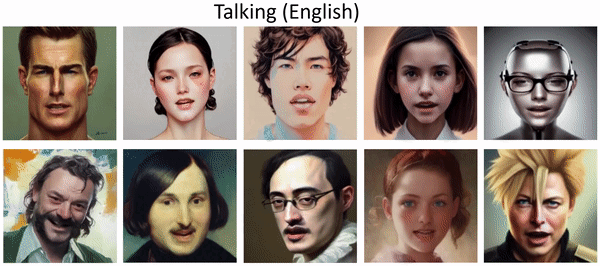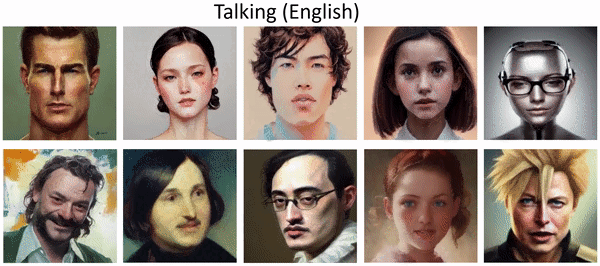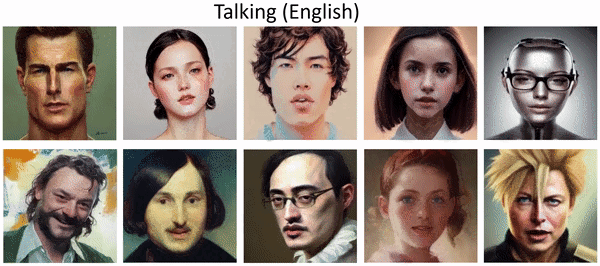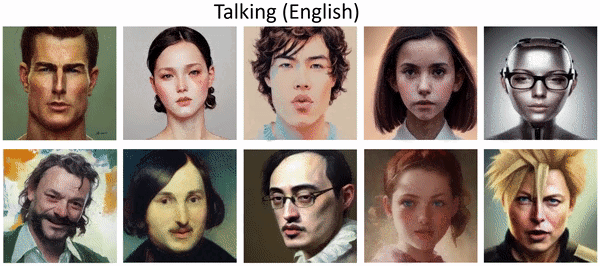
一张人像照片加一段音频,照片里的人就开口说话了。SadTalker 干的就是这件事:腾讯 AI Lab、西安交通大学等团队做的对口型模型,论文发在 CVPR 2023(arXiv 可查)。这几天我把它装进 AIGCPanel 在本地跑通了一遍。会说话的照片,正在把"拍一条视频"变成"丢进去一段素材"。
这次实测没上任何取巧配置:Apple M5 芯片、32GB 内存的 Mac,没有独立显卡,纯 CPU 推理。输入是一张 5.8MB 的人像照片和一段 1 秒的中文语音,参数全默认——256px 输出、裁剪模式、不开人脸增强。
| 项目 | 实测数据 |
|---|---|
| 环境 | Apple M5 / 32GB 内存 / macOS / 纯 CPU |
| 输入 | 人像照片 1 张 + 1 秒语音 |
| 推理耗时 | 约 7 分钟(其中逐帧渲染约 6 分钟) |
| 输出 | 256×256 H.264 视频,1.0 秒,约 32KB |
抽帧检查了一下:嘴部处于说话状态,眼镜、发型都保住了,人脸身份没有跑偏;256px 下细节略糊,属于这个分辨率的正常水平。CPU 上 7 分钟换 1 秒视频听着劝退,但这是没显卡时的兜底状态——模型包标称门槛是 GPU 4G+ 显存、8G+ 内存,有 N 卡速度快得多,CPU 档位的意义在于没显卡也能出活。
这是 SadTalker 官方 README 给出的公式。拆开看:先把照片拟合成 3D 人脸系数,把"表情"和"头部姿态"拆开来,再让音频驱动表情一路生成。相比早期直接把嘴型贴上去的做法,这种 3D 系数路线的头部动作更自然——实测视频里说话时有轻微的点头和摆头,幅度不大,但确实有。
模型包把这些选项全部做成了表单,在 AIGCPanel 里点选就行。
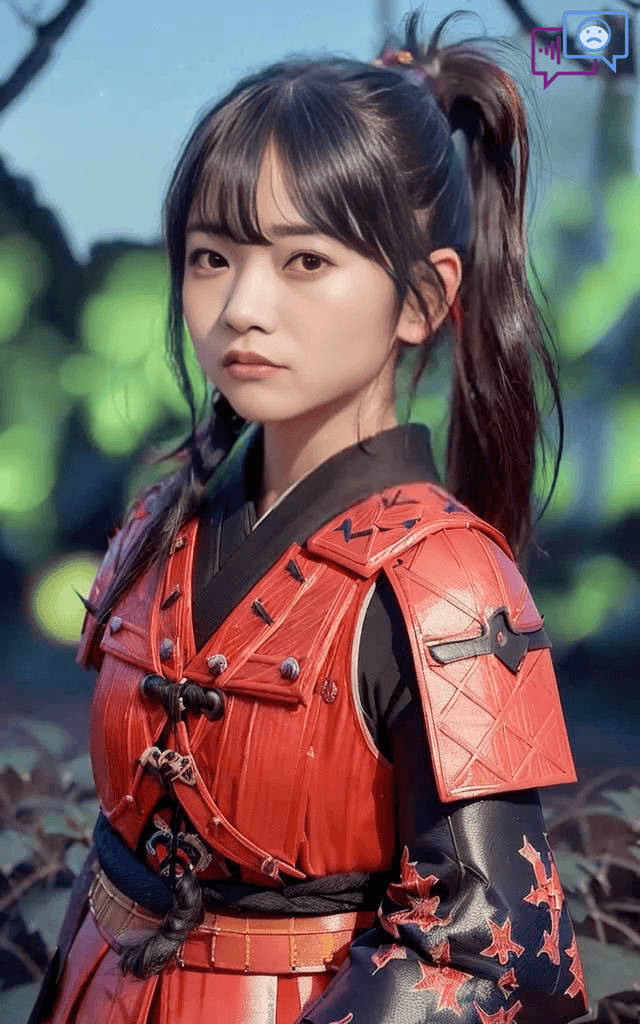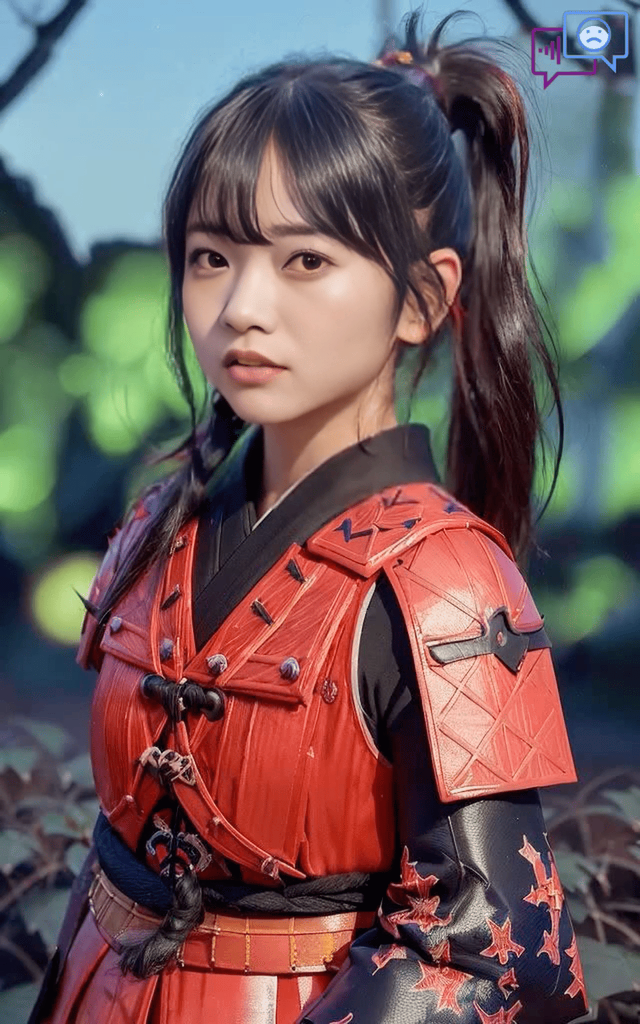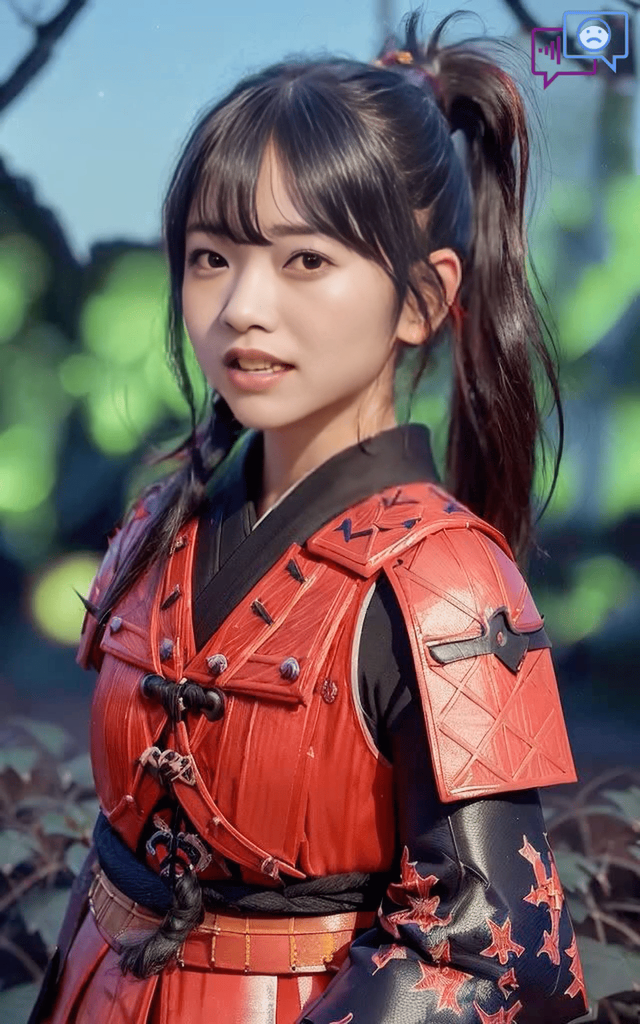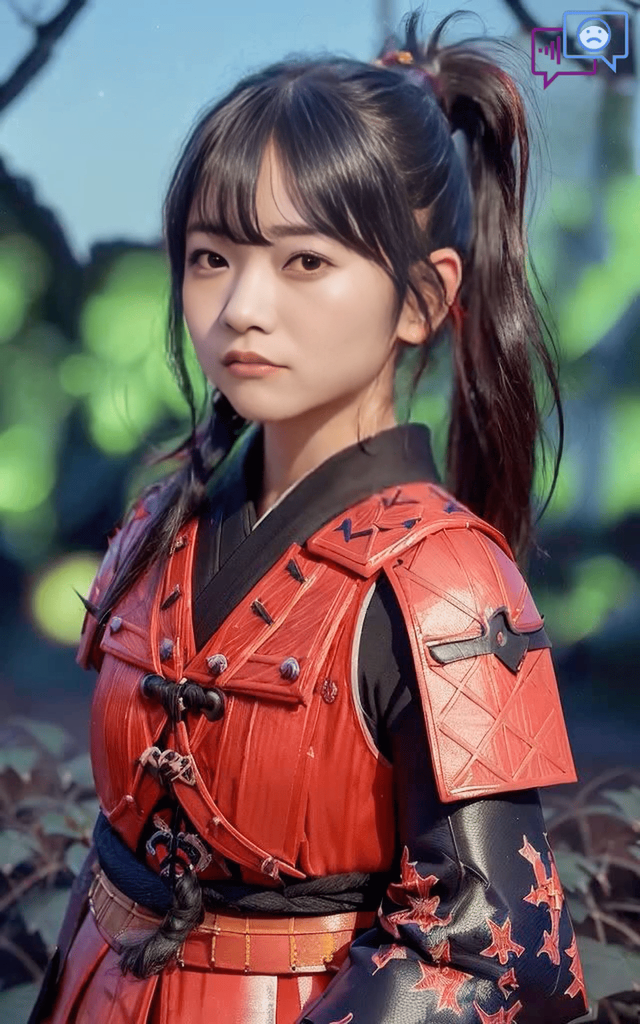
自己跑 SadTalker 源码,要建 conda 环境、装 ffmpeg、手动下载几 GB 权重、记一串命令行参数;在 AIGCPanel 里是四步:导入模型、选图选音频、表单调参、等视频出炉。说句公道话:AIGCPanel 首次同样要下载权重文件,省掉的是配环境那一整套流程,不是省模型本身。
门槛方面,模型包标称 GPU 4G+、内存 8G+,支持指定 GPU 序号,多卡机器各用各的;任务机制是有活儿时自动拉起、空闲就退出,不会一直挂着个大程序占显存。从官网下载页装好软件,在模型页拿到 SadTalker 一键运行包导入即可。官方对模型管理的描述是"本地模型一键导入、启动/停止、实时日志查看、参数配置",和实际体验一致。
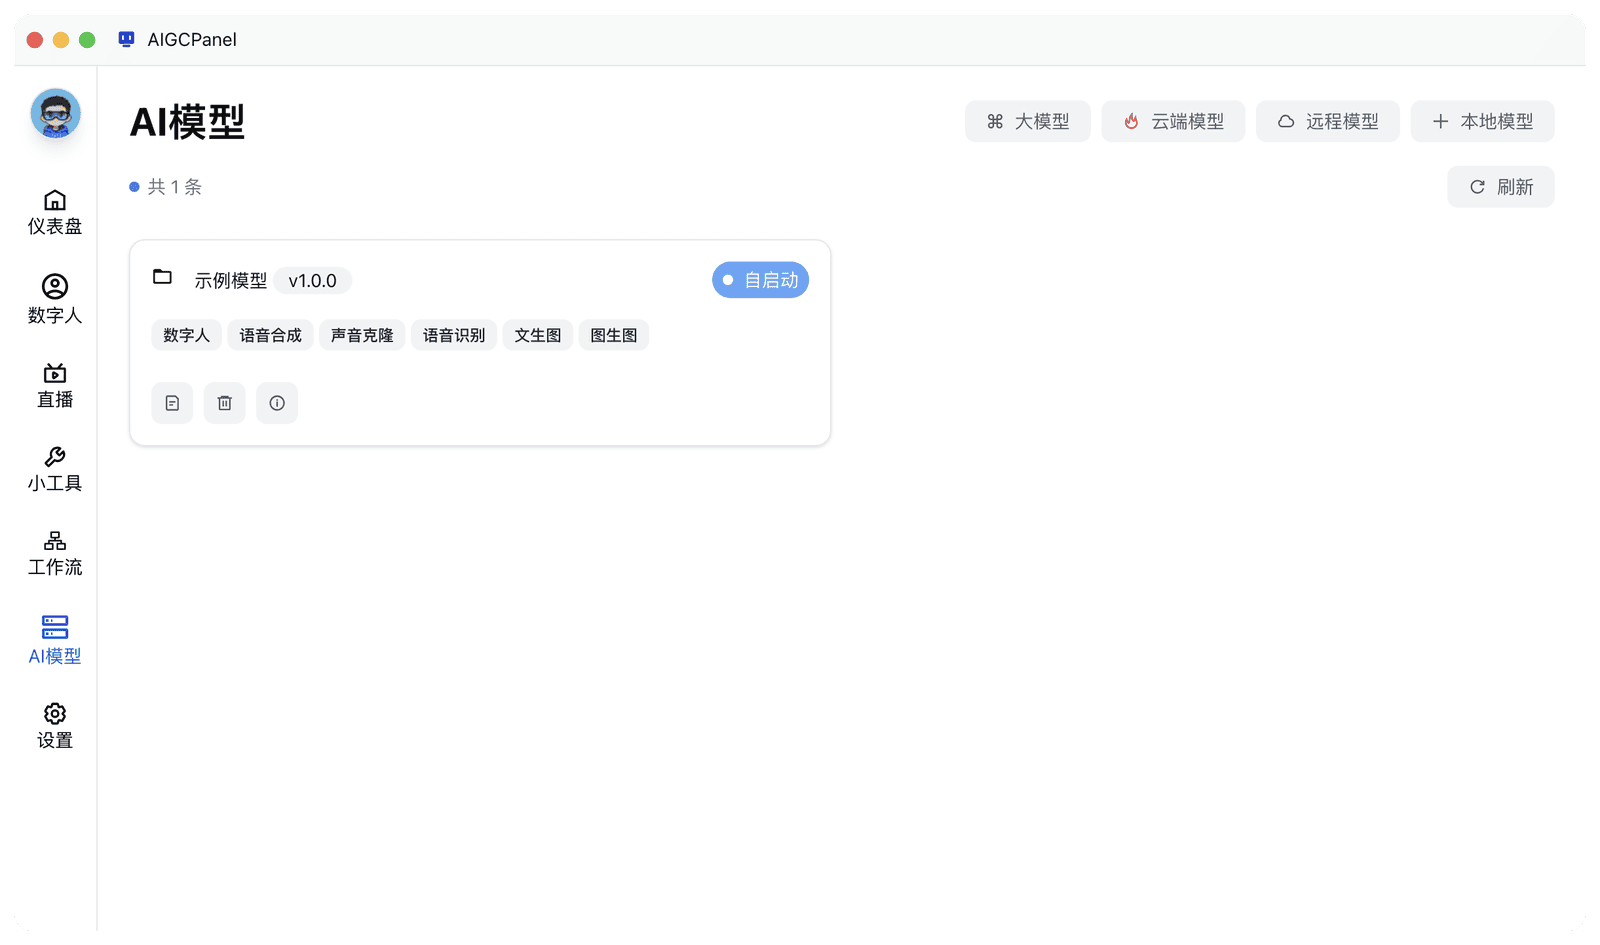
环境劝退了太多想玩 AI 的人,可真正该比拼的从来是创意,不是依赖。
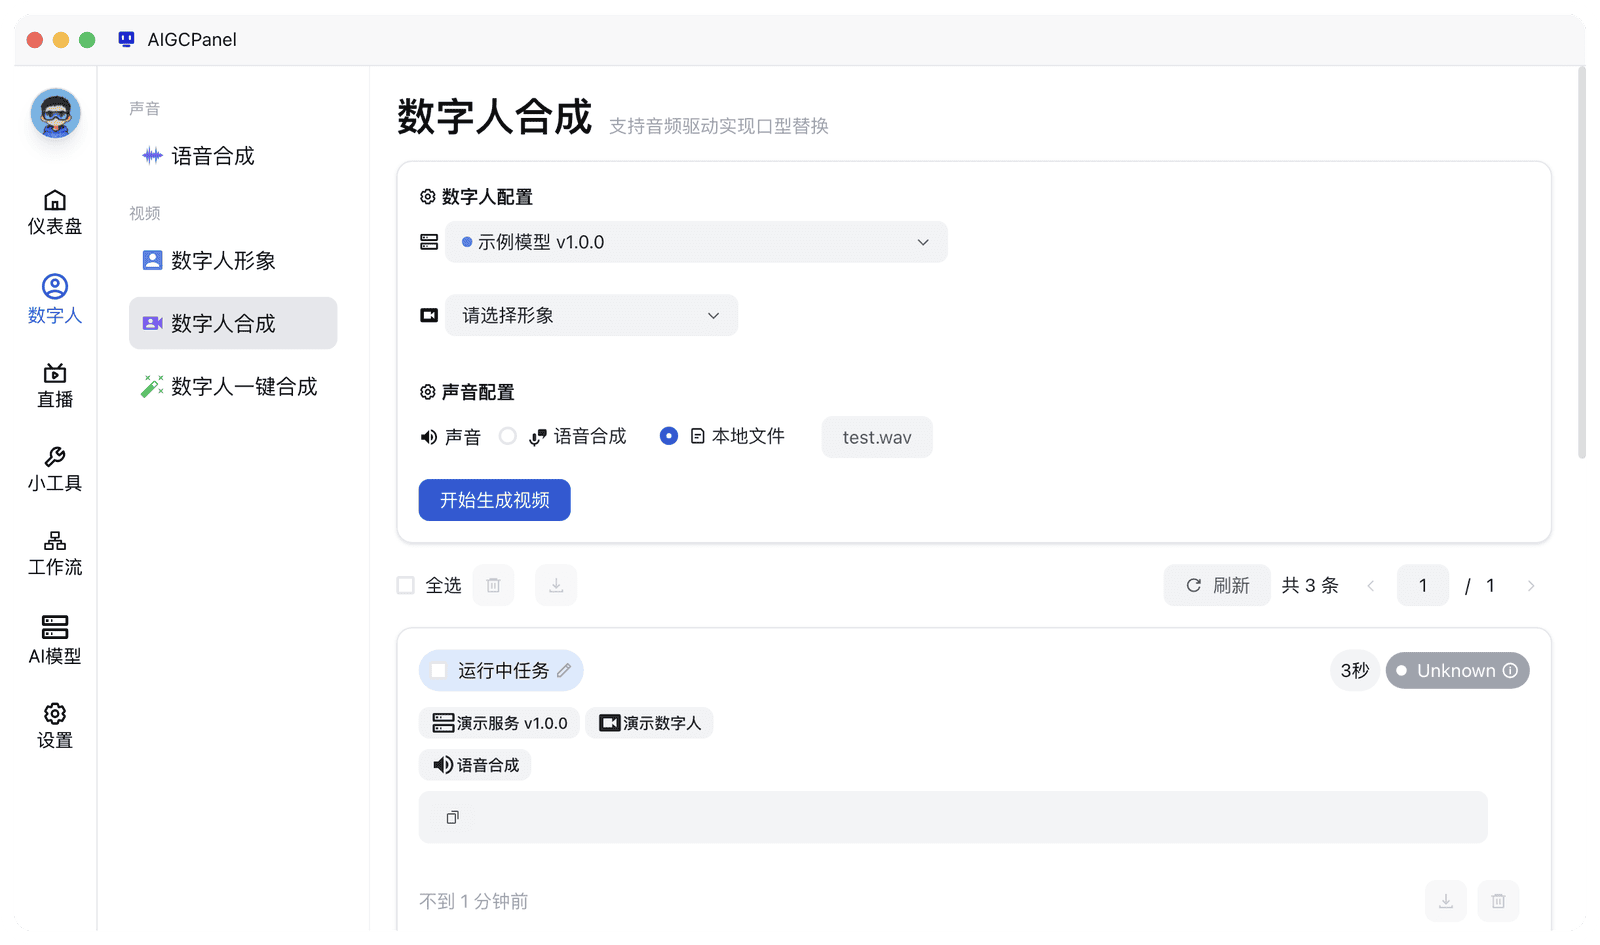
想让照片开口,路径已经很短了:下载 AIGCPanel,模型页拿包,导入,四步出片。
下一条刷屏的视频,起点可能只是一张照片和一段早就录好的音频。
你最想让哪张照片开口说话?评论区把它"安排"上。