QQ扫一扫联系
给一段视频、一段音频,它就能让画面里那张脸按着音频开口说话。
MuseTalk 是腾讯音乐娱乐集团天琴实验室开源的实时高清唇同步模型,专门解决"视频里的人怎么跟着音频动嘴"。它不重画人,只让画面里那张脸按着你给的音频动嘴,不改人脸,只改嘴。
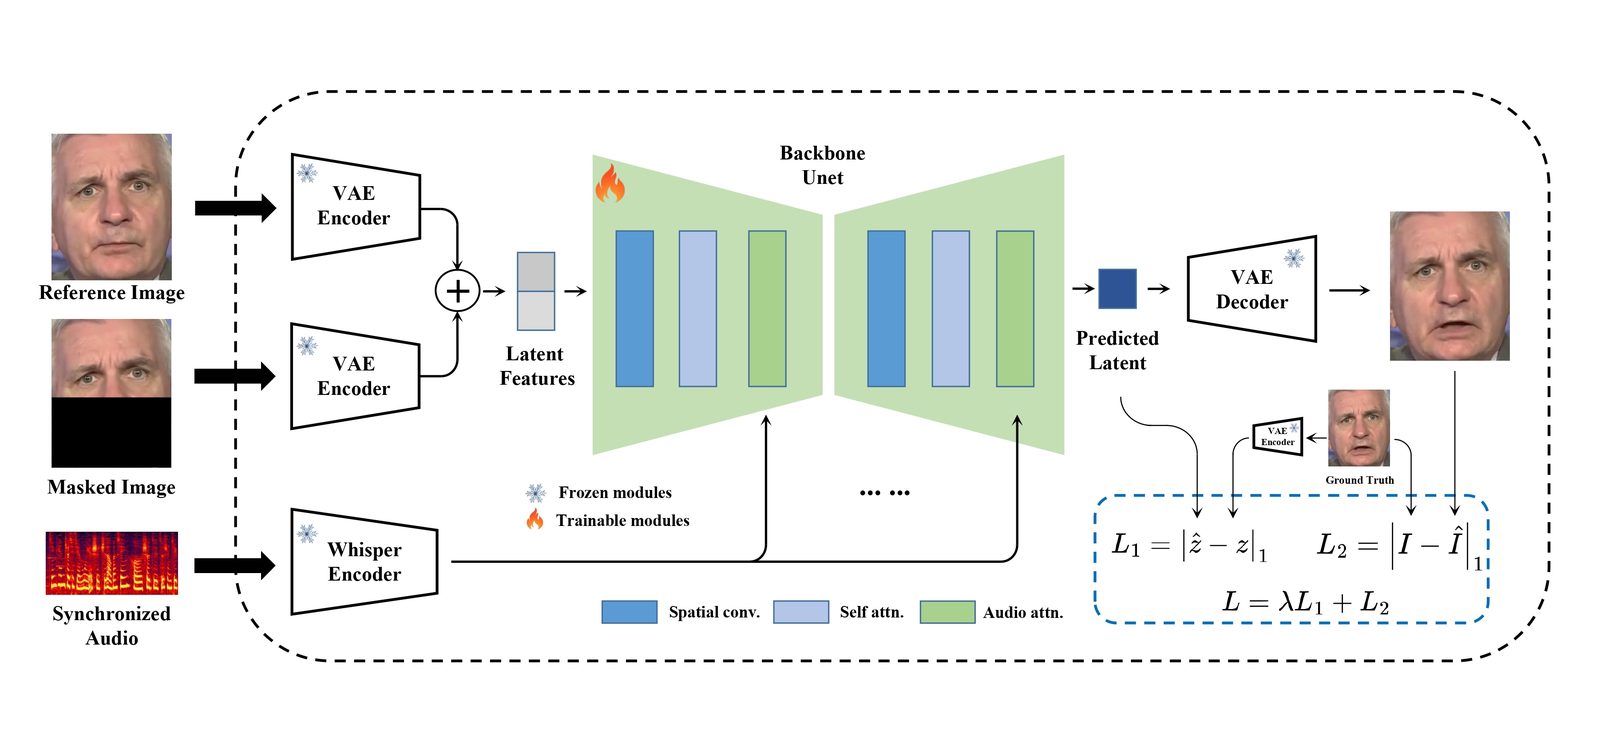
MuseTalk 1.5 把训练拆成两阶段,引入感知损失、GAN 损失与同步损失。用起来你能感觉到两件事:嘴型对得上,脸还是原来那张脸,不会越合成越"塑料"。
它只在 256×256 的人脸区域做精修,再贴回原视频,口型精度和整体画质一起保住。推理也不是常见的 diffusion 多步采样,而是在隐空间里单步补全,所以官方能在 NVIDIA V100 上跑到 30fps+ 的实时推理。
口型准不准,看的是嘴唇和声音的对齐;画面好不好,看的是合完还是原来那张脸。
音频用冻结的 whisper-tiny 提取特征,不挑语种,中文、英文、日文都能驱动。输入素材也不限于真人视频,官方 demo 里就有名画和插画,静态图片同样能让画面里的人"说话"。
官方给出的最低门槛是 RTX 3050 Ti Laptop(4GB 显存),fp16 模式下生成 8 秒视频约 5 分钟;AIGCPanel 打包版给出的建议配置是 GPU 6G+、内存 16G+,并适配了 50 系显卡。对个人创作者和小团队来说,手边一台游戏本基本就能开工。
自己部署过的人都知道,MuseTalk 的麻烦全在环境:Python 3.10、PyTorch 2.0.1 配 CUDA 11.7、mmcv / mmdet / mmpose 一整套 mmlab 依赖、还要单独准备 ffmpeg,权重文件又分散在好几个仓库里。
AIGCPanel 把这些步骤收进了一个桌面客户端:在模型市场下载 MuseTalk 一键运行包,导入模型,选好视频和音频,点合成即可。GPU 在设置里直接选,人脸框偏移、额外边距、融合模式这些参数也都在界面上可调,出问题不用去翻命令行日志。
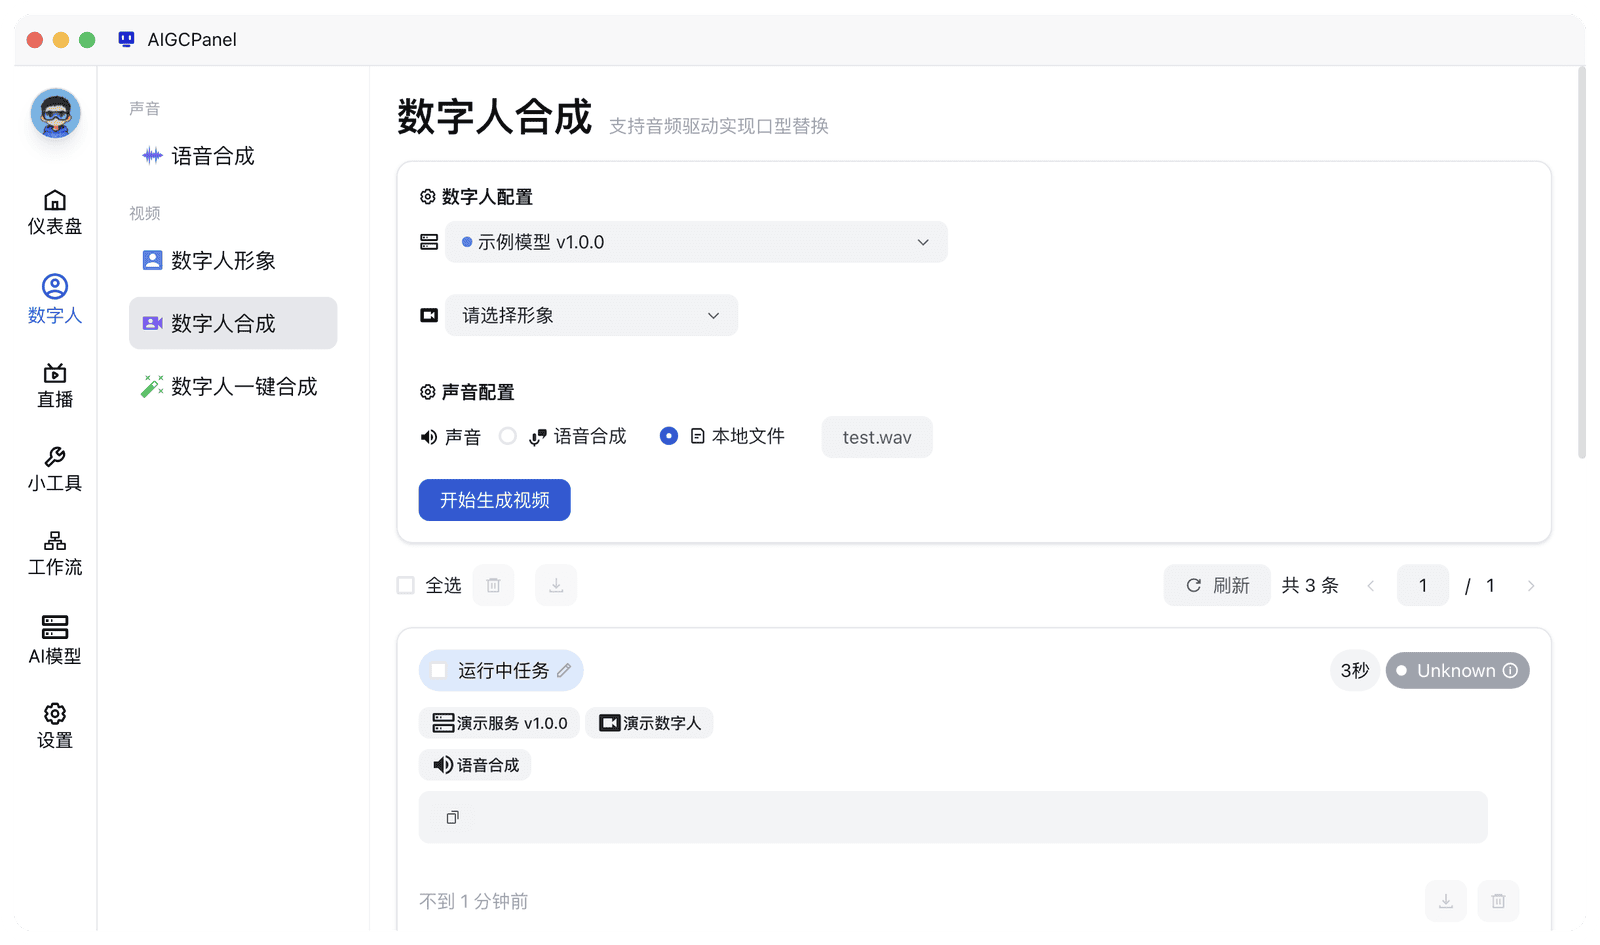
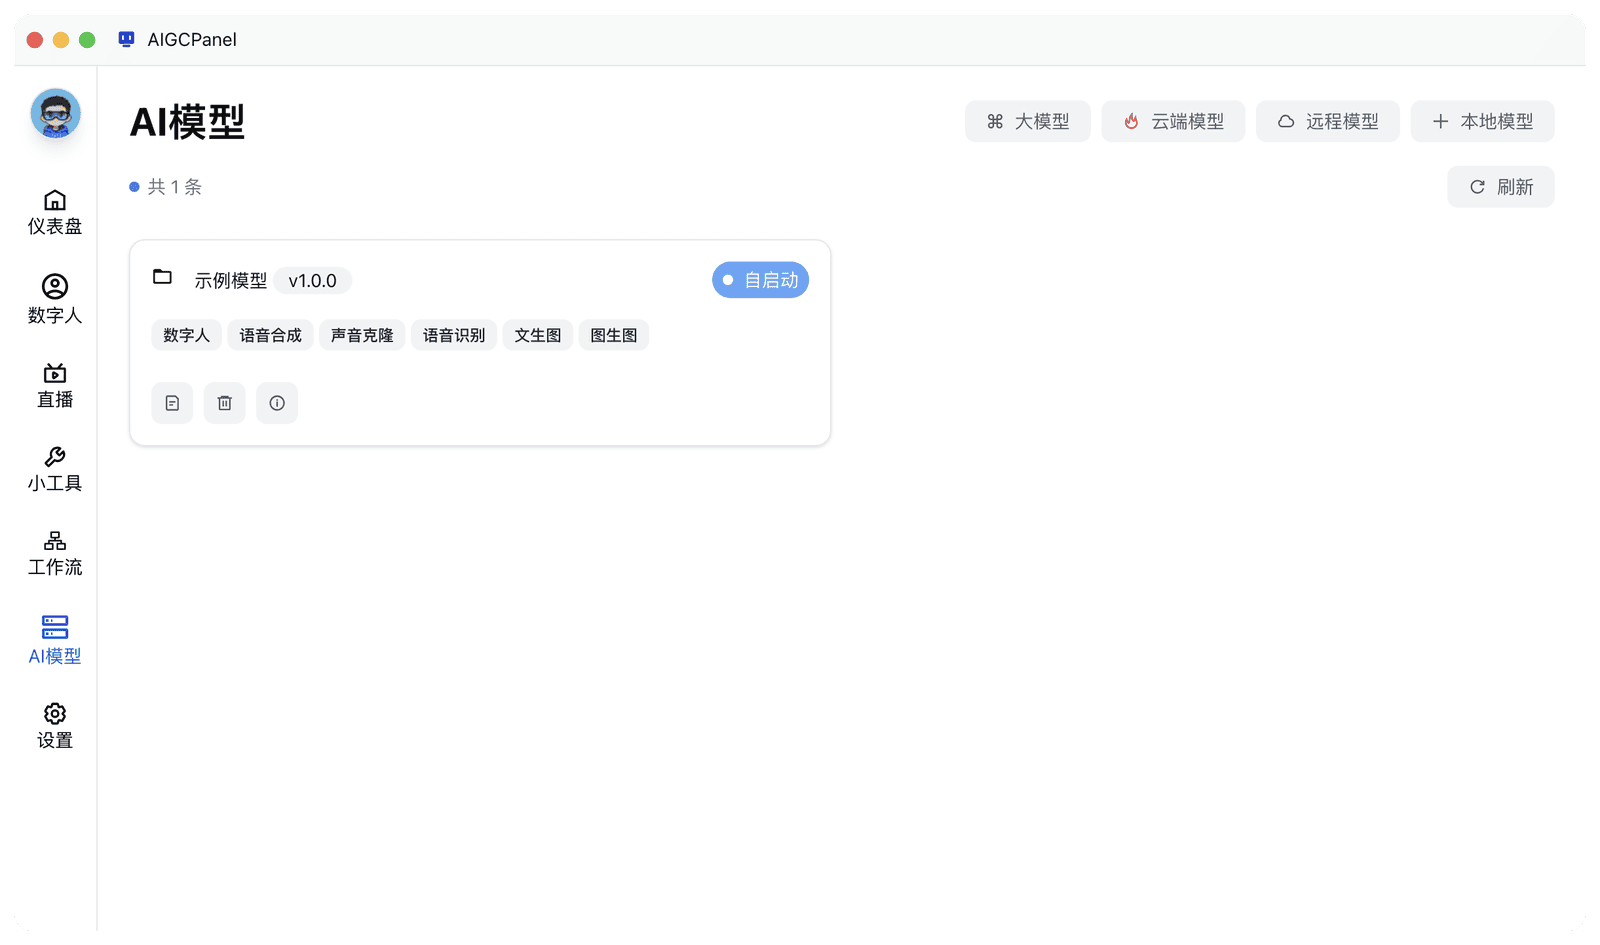
能三步跑通的模型,才有人真的用起来。
AIGCPanel 是一站式 AI 数字人桌面应用,MuseTalk 只是其中一块拼图:
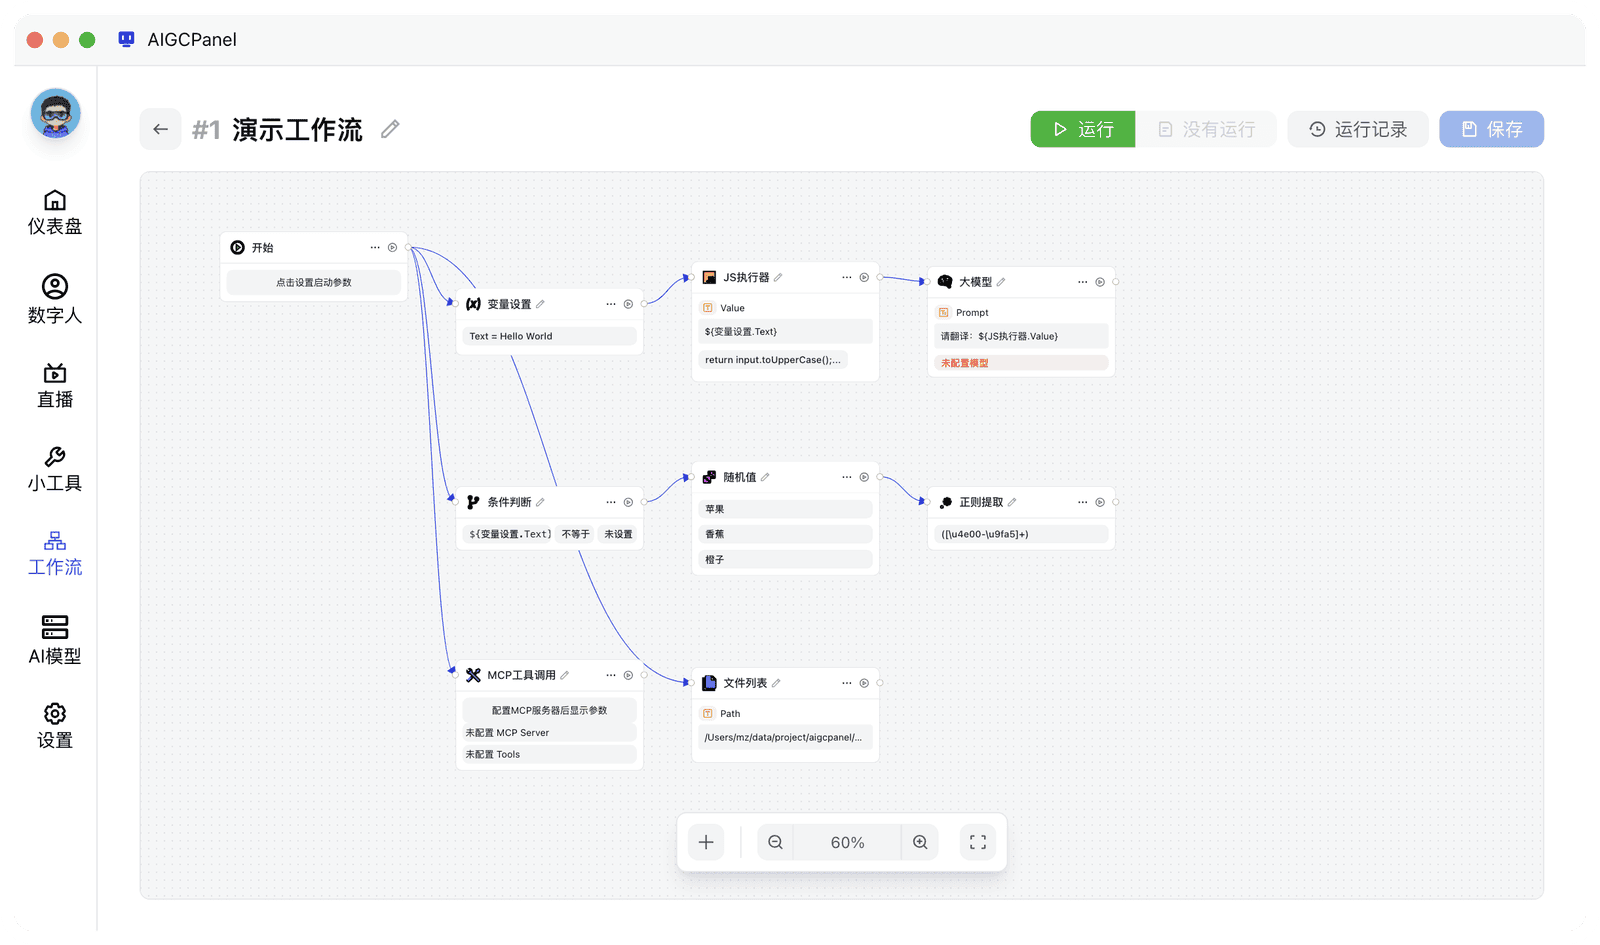
你手头有没有一段想"换口型"的素材?想让它用中文、英文还是日文开口?评论区聊聊。
数字人真正的门槛从来不是模型本身,而是从下载到跑通那十几步。