QQ扫一扫联系
一段英文口播稿丢进去,等十几秒拿到 24kHz 的 wav,不用开云端会员,稿子也不用上传。Hume AI 这个 1B 的语音模型,现在能在你自己的电脑上跑起来了。
Hume AI 开源 TADA 时讲的是一件很朴素的事:让语言模型直接开口,中间不经过音素表和声码器。TADA-1B 是家族里的 1B 版本,底座是 Meta Llama 3.2 1B;更大的 TADA-3B 才管多语言,这一版只认英文。
一个 10 亿参数的模型,念完 3 分钟口播只要十几秒,这条配音流水线已经可以放在你自己的硬盘上了。
⚡ RTF 0.09:官方图表里最快的一档
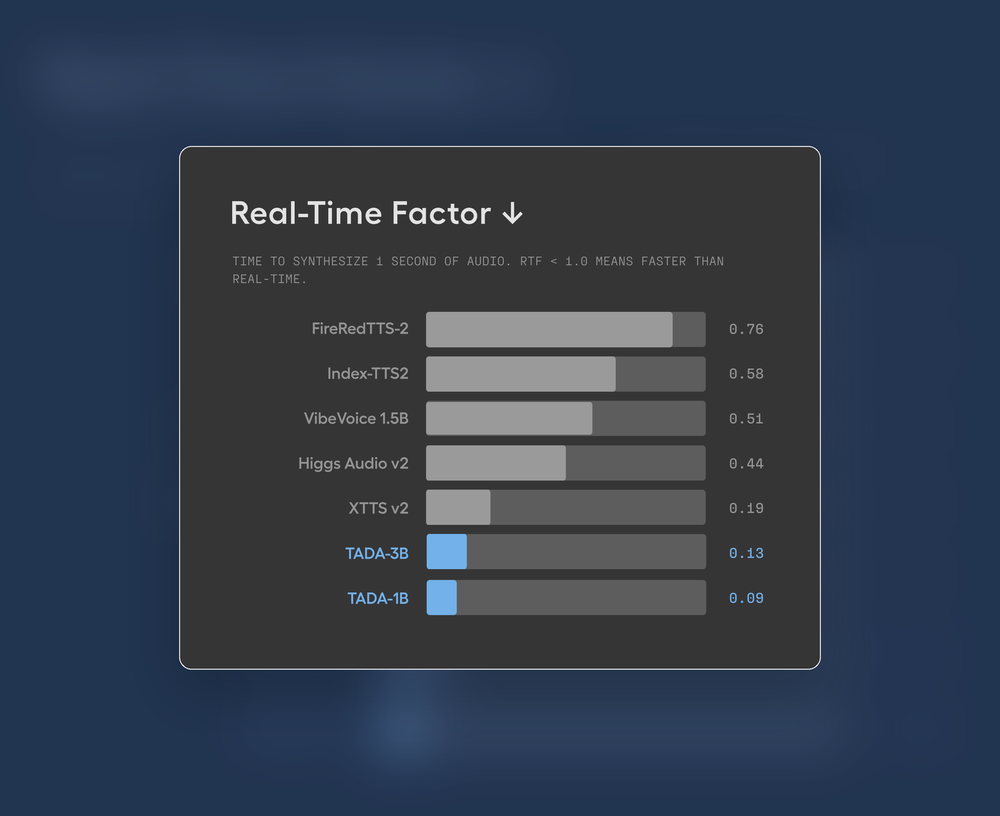
RTF 就是实时因子,合成 1 秒音频要花的秒数,越小越快。0.09 意味着 1 秒音频用 0.09 秒算完,大约 11 倍实时。
Hume AI 官方对比图里,TADA-1B 是 0.09,XTTS v2 0.19,Higgs Audio v2 0.44,VibeVoice 1.5B 0.51,Index-TTS2 0.58,FireRedTTS-2 0.76。同样 1B 量级的 VibeVoice,慢 5 倍多。
按官方这个 RTF 推算:
| 稿子长度 | 预计合成耗时 |
|---|---|
| 1 分钟音频 | 约 5 秒 |
| 3 分钟音频 | 约 16 秒 |
| 10 分钟音频 | 约 54 秒 |
这是官方评测环境下的数,换到你的机器上会随显卡和切句策略有出入,8G 卡只会更慢,不会更快。真要拿它压工期,还是得自己跑一段试试。
🎯 1:1 对齐:官方 1088 条样本里零漏词
TADA 让每个文本 token 对应一个语音向量,自回归每走一步就写完一个 token 的声音,时长和韵律由模型当场决定。它没有固定帧率,也就不存在按每秒 50 帧硬切带来的那些偏差。
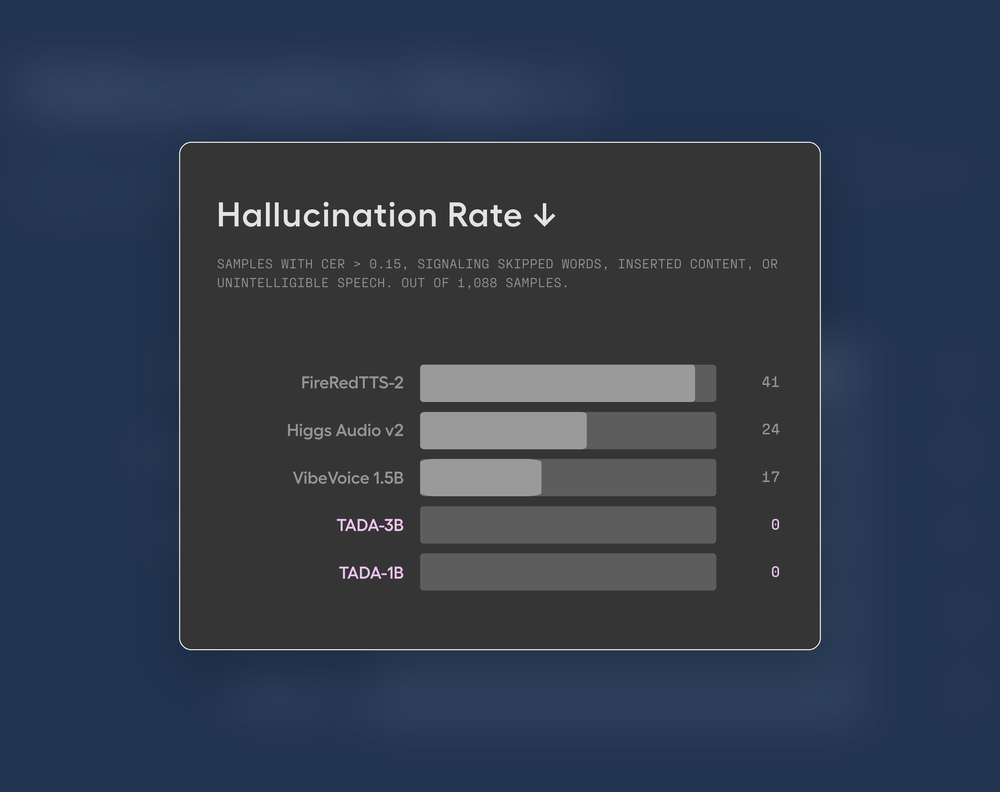
官方在 1088 条样本上统计 CER 大于 0.15 的条数(漏词、加词、听不懂都算):TADA-1B 和 3B 都是 0 条,VibeVoice 1.5B 17 条,Higgs Audio v2 24 条,FireRedTTS-2 41 条。长稿子尤其该看这个数,音色再像,中间飘掉一句也是白做。
长稿子里最难查的 bug,是一句话莫名漏了词;这种错你在成品里很难听出来,只能靠架构一开始就不给它机会。
🎙️ 5~15 秒参考音频,音色跟着走
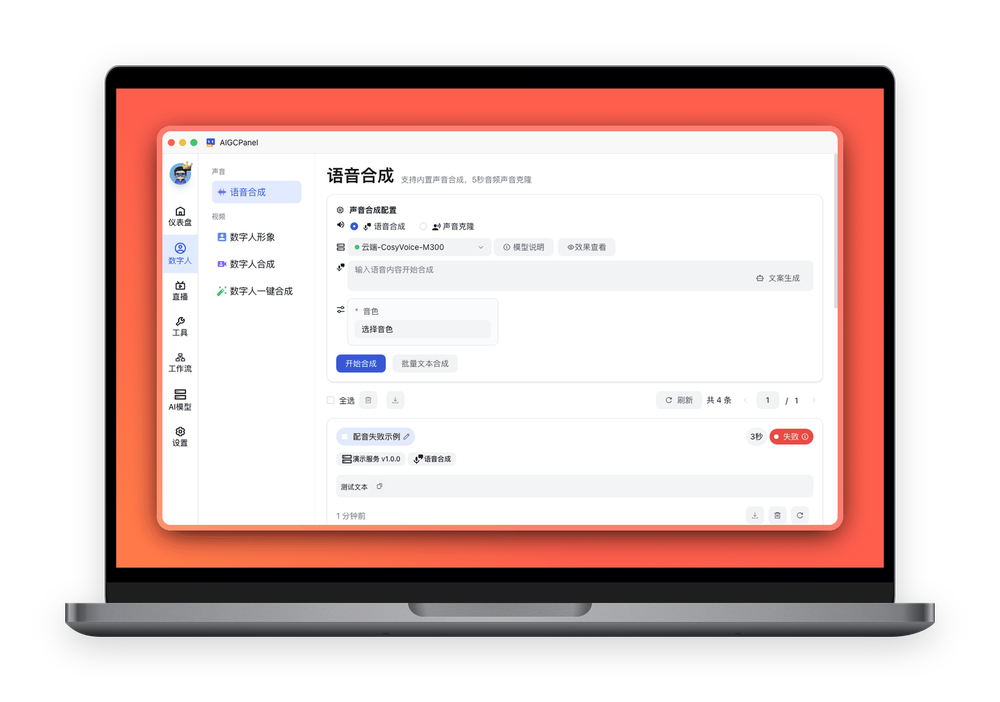
零样本克隆,不用训练。在 AIGCPanel 的语音合成页切到「声音克隆」,传一段 5~15 秒清晰、无背景音乐的英文音频,再填上这段音频对应的英文文本,就能用那个音色念新稿子。
参考文本这一步不能省。TADA 靠参考音频和文本做强制对齐,缺了它或者填了段不相干的字,音色和发音都会跑偏,所以服务端不填直接报错,让你补齐再合成。
输出是 24kHz 的 wav,导出后直接拖进剪辑软件就能用。同一个音色连着合成时,参考音频的编码结果会被复用,不必每段都重新编码;文本也会按句切开逐句生成再拼接,长稿子不用你自己分段。
📦 装之前先看两条限制
只支持英文。 TADA-1B 是纯英文模型(HuggingFace 模型卡标的就是 en)。判断的是你输入的合成文本,不是参考音频:中文、日文、韩文丢进文本框,服务端直接拦下来提示换英文,因为硬着头皮生成的是一串听不懂的英文乱音。
中文输入法敲出来的全角逗号、句号、全角空格会被自动转成半角,正常的英文稿子不会被误判。参考音频本身是中文音色、文本填英文也能跑通,只是对齐质量会掉,官方文档里也是这么写的。
要中文配音,去装 TADA-3B,那是这个家族多语言的那一版。
一键运行包目前只有 Windows x86。 模型市场里上架的是 TADA-1B v1.0.0,2026-11-15 发布,免费,标注 GPU 8G 显存起步、内存 16G+、支持 50 系显卡。macOS 和 Linux 的用户现在得自己从源码构建这个模型服务。
🚀 装起来是三步
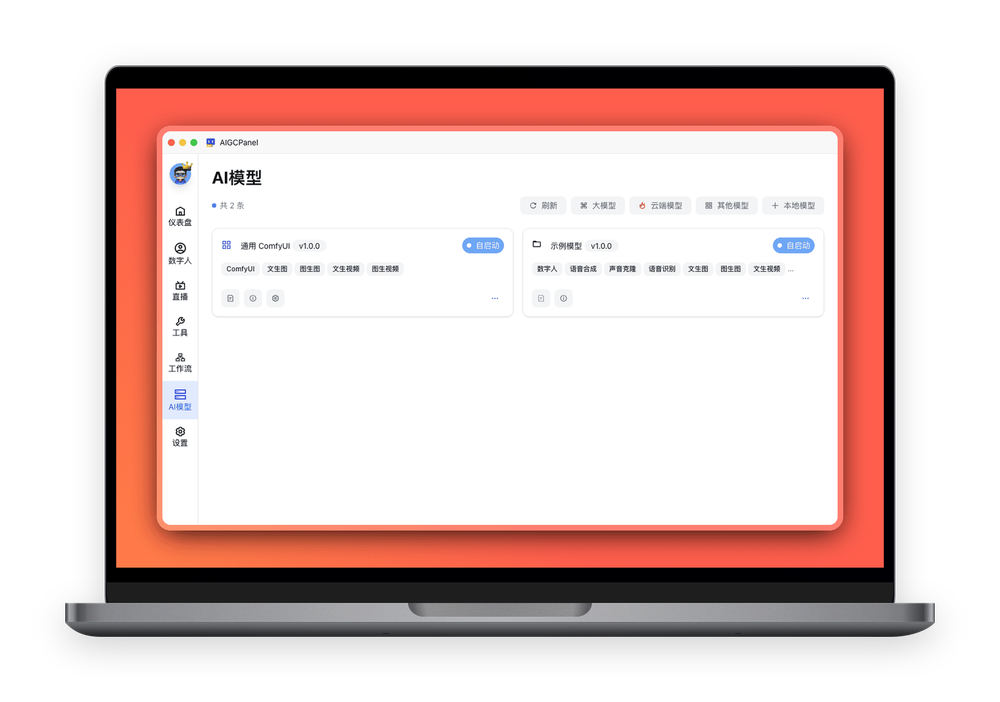
包内自带运行环境(PyTorch CUDA 12.8),不用自己装 Python 和 CUDA。模型只加载一次:服务常驻着轮询任务,一个跑完继续等下一个,空闲 60 秒才退出,权重不用每个任务重读一遍。
想在终端里批量跑,一条命令也能调:
aigcpanel serverCall --server server-TADA1B --function soundTts \
  --text "Please call Stella. Ask her to bring these things with her from the store."
机器没有可用 CUDA 时会自动降级到 CPU 跑,不会启动失败,只是慢到不适合长稿子。
📚 整章稿子直接丢进去
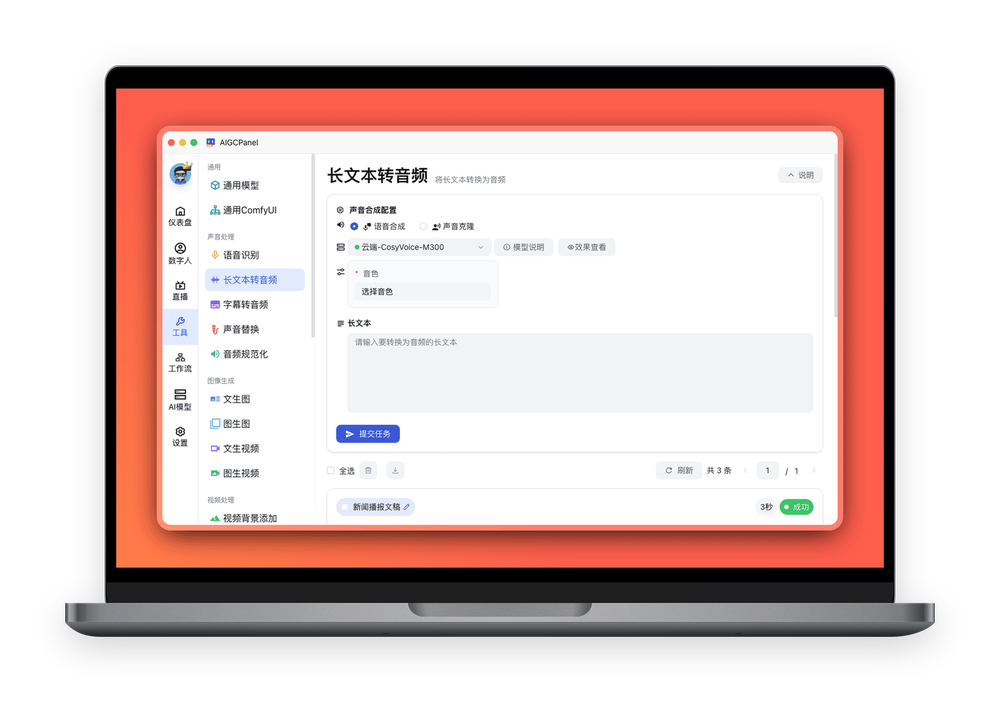
工具箱里的「长文本转音频」把整章文字贴进去,选好音色提交就行,结果在任务列表里下载。前端走的还是同一个模型服务,切句、合成、拼接都在服务端完成。
什么时候别用它
要中文、日语、德语,换 TADA-3B。要情感控制、多档情绪、高并发批量出活,云端接口更省事。TADA-1B 的甜点区是英文长稿:有声书、课程旁白、产品口播、数字人的英文音轨。
许可也顺便说清楚:模型权重走 Llama 3.2 社区许可,代码是 MIT,AIGCPanel 本身 Apache-2.0。想把成品拿去商用,按 Llama 3.2 的条款自己核一遍,别默认「开源就是随便用」。
你手头的英文稿子有多长?1 分钟、3 分钟还是一整章?留言说个长度和用途,我按上面的推算表帮你估一下本地要等多久。
官方数字决定值不值得试,你的耳朵决定用不用,先用 RTF 和漏词率把不合适的筛掉,最后一定拿自己的稿子试听一遍。