QQ扫一扫联系
一台只有 2G 显存的旧机器,也能在本地念出一段像样的中文配音,这件事比想象中简单。
Kokoro-82M 是 hexgrad 开源的语音合成模型,8200 万参数,Apache-2.0 协议。2025 年 2 月发布的 v1.1-zh 版本补了 100 个中文音色,整包只保留中英双语。AIGCPanel 是一个开源桌面客户端,模型市场里能直接下到这个模型的运行包。模型早就够用了,难的是把它装进一台普通电脑。
模型卡在 huggingface.co/hexgrad/Kokoro-82M-v1.1-zh,代码在 github.com/hexgrad/kokoro。
中文音色来自龙猫数据的专业录音,训练数据超过 100 小时;英文只有三个:美式女声 Maple、美式女声 Sol、英式年长女声 Vale。编号从 001 跳到 017 是上游的音色 ID,不是文件缺失。
中英混排是它顺手的地方。中文音色走中文流程,句子里冒出来的英文单词交给英文 G2P 处理,再拼回同一条音轨;反过来不行,英文音色念中文会乱。缩写、型号(RTX 4090 这类)最容易读错,先拿一句混排试试。
音色、语速、随机种子都写在运行包的 config.json 里,103 个选项直接渲染成下拉框。自己往 voices 目录里丢一个 .pt 文件不会自动出现在列表里,想加音色得改配置。
第一步,装客户端。aigcpanel.com 下载,Windows 的 .exe、macOS 的 .dmg、Linux 的 AppImage 和 deb 都有。
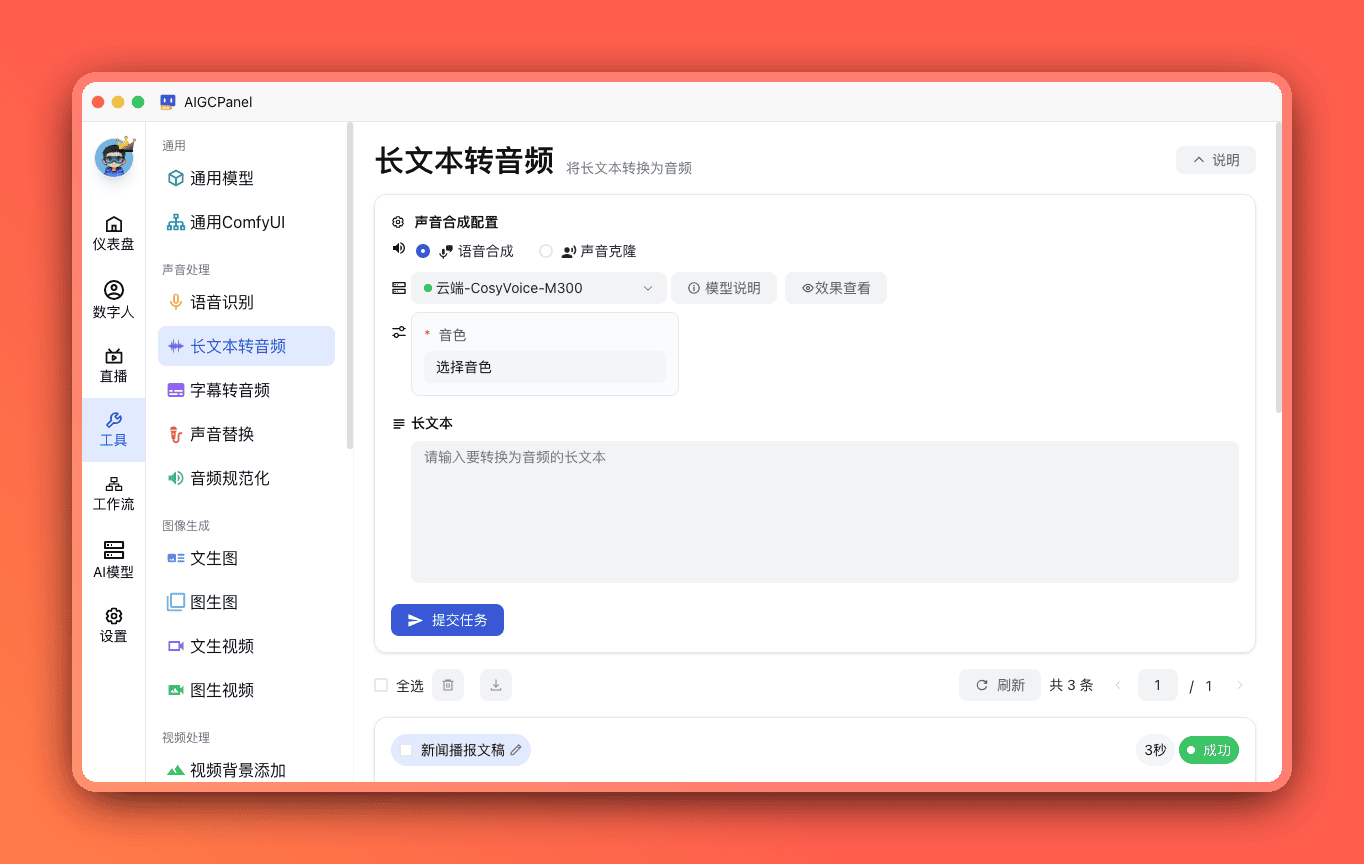
第二步,拿模型。打开「AI 模型」,点「+ 本地模型」,弹窗里两个按钮:「下载」跳模型市场(aigcpanel.com/zh/asset),「选择本地 config.json」做导入。市场里搜「Kokoro 82M」,下载运行包——这个包目前只提供 Win-x86 版,macOS 和 Linux 的客户端能装,但这个模型暂时跑不了。解压后目录里应该有 config.json、kokoro-v1_1-zh.pth 和 voices 文件夹,三样必须待在一起,导入时选 config.json,程序会去同目录找权重和音色,别只把 config.json 拷出来。
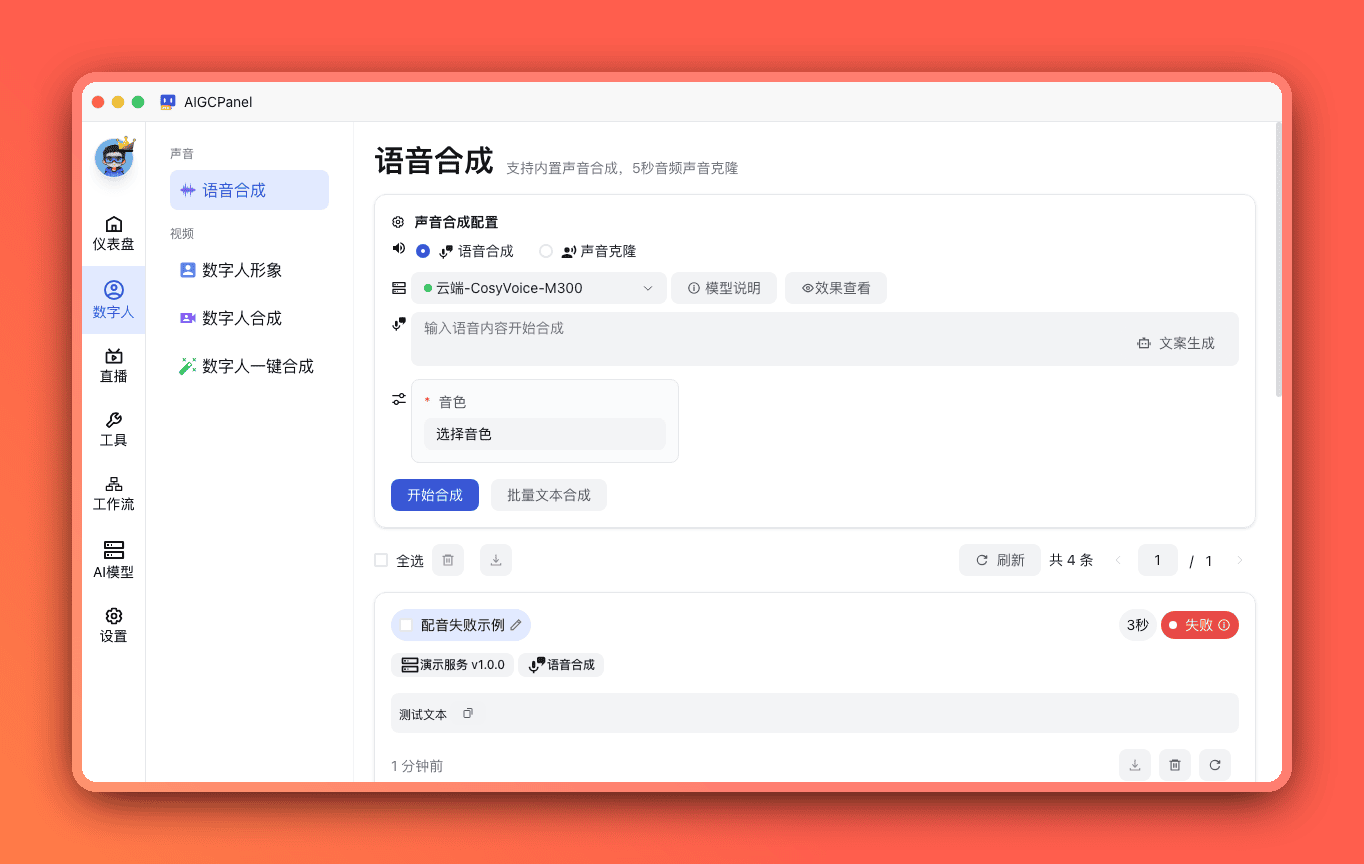
第三步,出声。回到「AI 模型」页,在卡片上点绿色的播放按钮启动(也可以打开「自启动」,下次开客户端自动拉起)。等日志里出现加载完成的字样,再去「语音合成」选 Kokoro82M,挑一个音色,粘贴文案,点「开始合成」。任务列表里会多一条记录,下载下来就是 wav;多条文案可以用「批量文本合成」一次提交。
每一步做完都应该看到明确的变化:模型卡片从停止变成运行中、日志开始滚动、任务列表里出现新记录。卡在哪一步,就是那一步没走完。
没有 conda,没有 pip,也没有对不上的 CUDA 版本。代价是运行包自带一套 Python 环境,所以包体不小。省下来的不是配置时间,是你愿意再试一次的耐心。
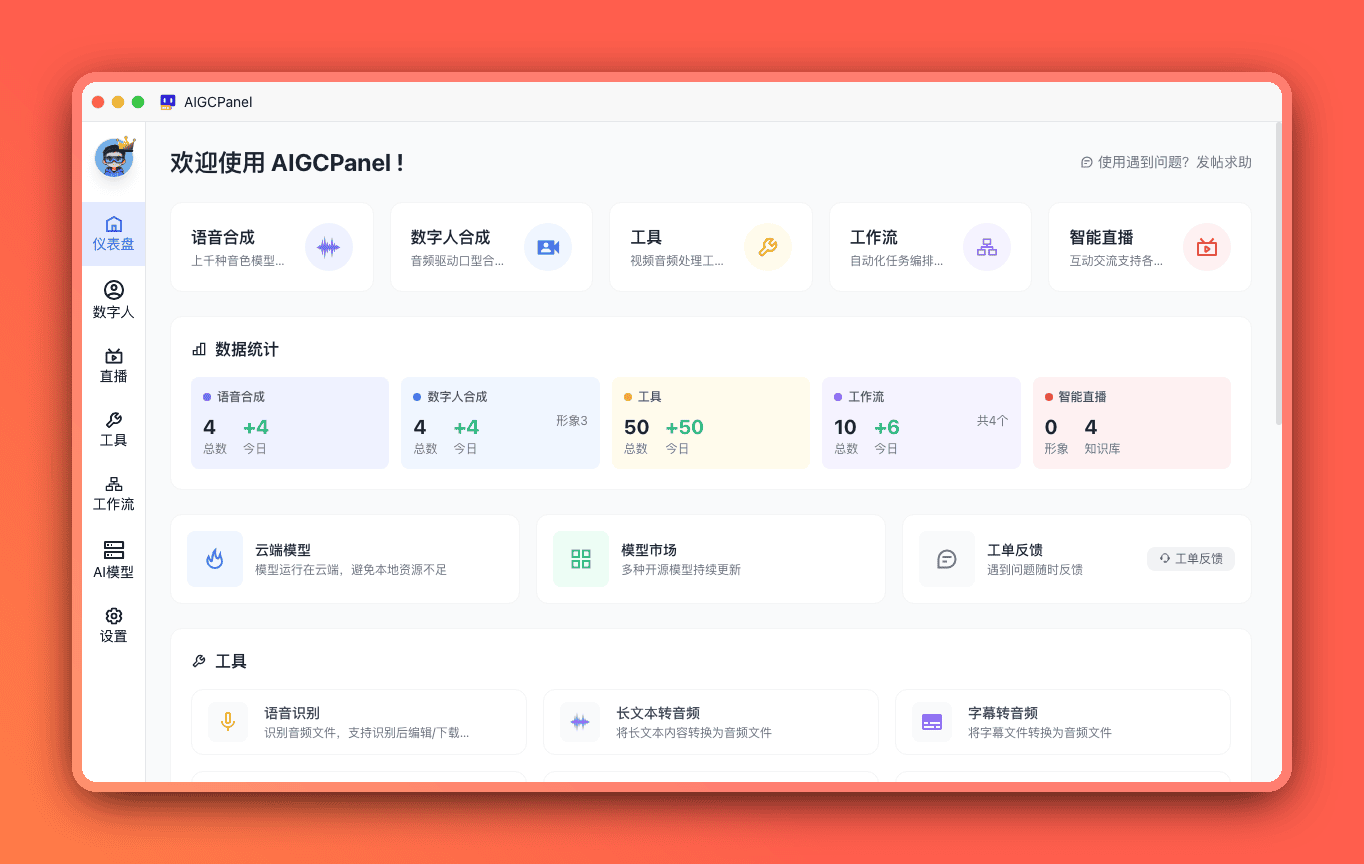
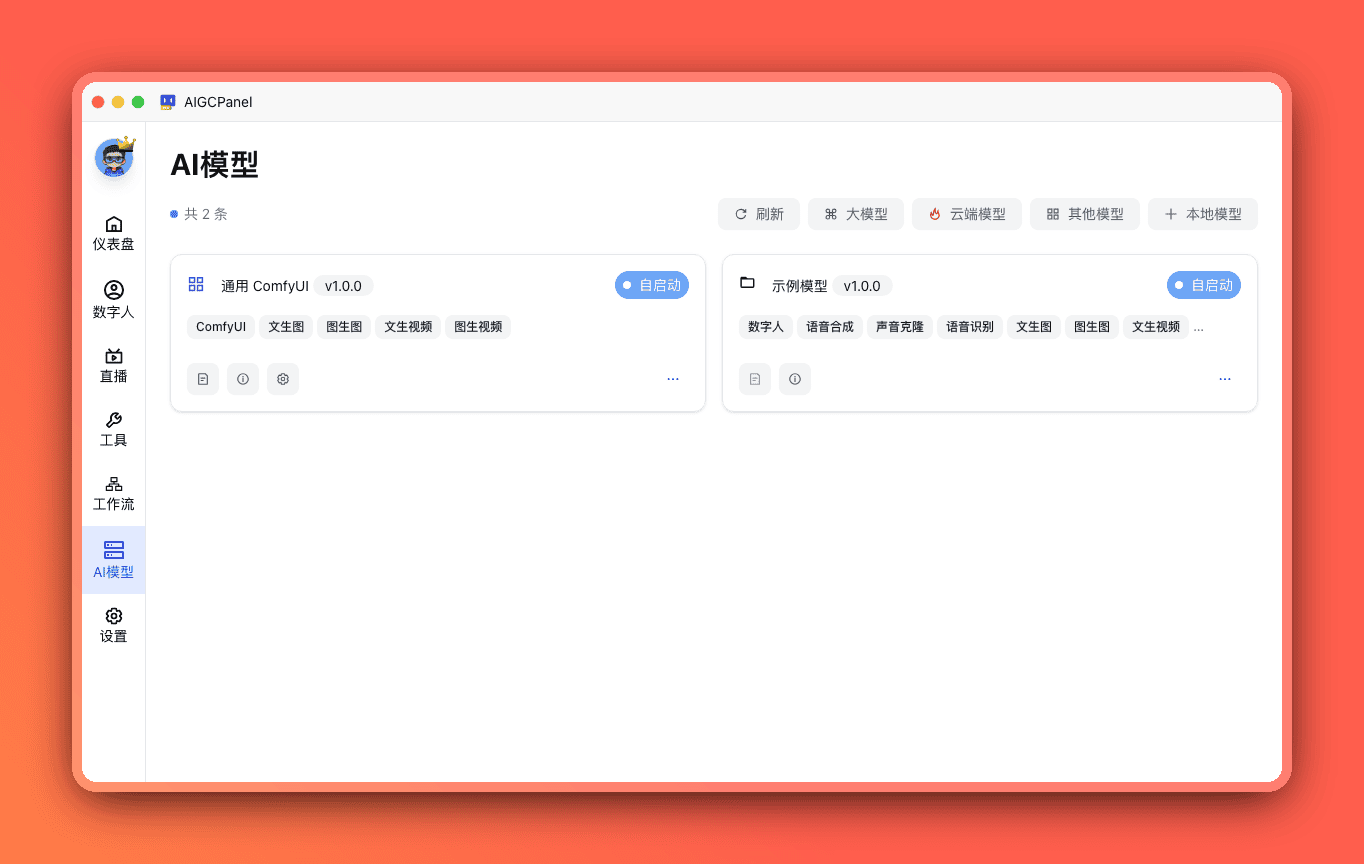
配音稿动辄几千字,一段段粘贴会疯。「工具 → 长文本转音频」把整篇丢进去就行,但先把模型下拉框从默认的云端模型切成 Kokoro82M——不切的话,稿子是发到云上去合成的,跟「本地跑」正好相反。
后台拿到文本先按标点切碎,再拼成每段不超过 150 字的块,逐块合成,块之间补 0.1 秒静音。所以长稿听起来会比单句合成略微顿一点,这是正常的。
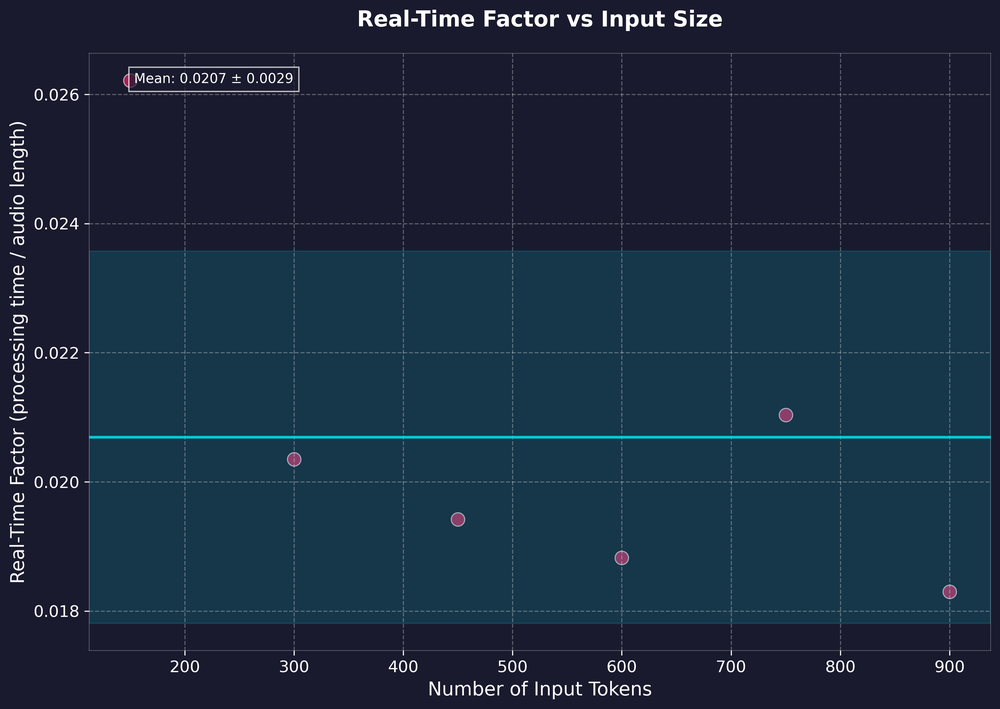
按上游压测的实时因子 0.0207 算,1 分钟音频的推理时间大约 1.2 秒。这组数字是 GPU 环境、只算模型推理得到的,算上文本处理、分块和写盘会更长,CPU 上还要再慢一截。
语音合成只是入口。数字人合成里,声音来源可以选「语音合成」,让语音模型先生成音轨,再交给 MuseTalk、LatentSync、Wav2Lip、Heygem 这些口型模型去对口型;字幕转音频、长文本转音频这些工具,底下干活的也是同一个模型。模型在「AI 模型」里装一次就够了,其他页面取的是同一份列表。
情感表演、方言、多角色对话、歌声,这些都不是它的强项;它一次生成整段 wav,也不是给实时语音对话准备的。念错数字和多音字,最有效的办法是在文本里改写,「2026」写成「二零二六」,多音字换成同义词,比调参数有用。
和云端 TTS 比,它免费、离线、不限字数、没有调用费;音质和情感表现不如商用云服务,还要占一点磁盘和内存。权重是 Apache-2.0,商用前按协议自行确认。
如果你手边正好有一台吃灰的机器,装上 AIGCPanel,把 Kokoro-82M 拉下来,让它念一段你自己写的字,听听像不像。
你打算拿它配什么?口播稿、有声书,还是游戏里 NPC 的台词?一个模型只有便宜到随手就能试,才会被真的用起来。