登录
首页
下载
模型
文档
讨论
需求墙
开源
Github开源
Gitee开源
新闻资讯
MuseLip(网页版)
🔧 基础安装与使用
📚 使用前需要了解的基础知识
🔧 AIGCPanel 软件安装
💻 Windows 系统安装 AIGCPanel
🍎 Mac 系统安装 AIGCPanel
🖥️ 银河麒麟 Kylin 安装 AIGCPanel
🖥️ 统信 UOS 安装 AIGCPanel
🧠 AIGCPanel 本地模型使用
🧠 AIGCPanel 云模型使用
❓ 遇到问题如何提交工单
🔧 软件安装使用常见问题
🤖 【开源自荐】开源AI数字人 AIGCPanel
🌐 多语言切换说明
🧭 软件界面功能总览
🔄 软件升级与版本更新
💾 数据备份与恢复
🗑️ 卸载软件说明
🔊 声音视频处理
🔊 声音复刻步骤
🔊 声音合成步骤
📝 语音识别步骤
🔊 视频声音替换
🔊 云端声音合成音色预览
📖 【教程】免费 AIGCPanel➕CosyVoice 声音合成和声音复刻
📖 【教程】免费 AIGCPanel➕IndexTTS 声音复刻
📖 【教程】免费 AIGCPanel➕CosyVoice 声音合成和声音复刻
📖 【教程】免费 AIGCPanel➕IndexTTS 声音复刻
🔊 声音复刻步骤
📜 长文本合成指南
🎙️ 声音复刻最佳实践
🎛️ 声音合成参数详解
🎚️ 音频格式与质量指南
🤖 数字人视频
🎬 视频合成步骤
👤 数字人形象录制要求
🎯 口型同步优化技巧
📚 批量视频合成
⚙️ 视频合成参数说明
🧠 视频模型选择指南
❓ 数字人视频常见问题
📤 数字人视频导出与分享
💼 数字人视频应用场景
🖼️ 形象视频管理
📺 数字人直播
📺 直播电脑硬件要求
🤖 数字人形象录制要求
⚙️ 直播推流配置
⚙️ 数字人直播推流配置
⚙️ 语音直播推流配置
⚙️ 平台开播配置
📖 抖音开播教程
📖 快手开播教程
📖 小红书开播教程
📖 视频号开播教程
📖 哔哩哔哩开播教程
📖 淘宝开播教程
📖 拼多多开播教程
📖 美团开播教程
📺 直播互动功能和实时回复
❓ 直播常见问题
🚀 数字人直播快速开始
🎞️ 直播画面优化
✍️ 直播话术设计指南
📊 直播数据复盘
📚 直播知识库配置详解
🔀 工作流
🐞 工作流调试与排错
📦 工作流批量处理指南
🏆 工作流实战案例
❓ 工作流常见问题
🔗 工作流变量与数据引用
🔧 基础节点
文件列表节点(FileList)
文件移动节点(FileMove)
正则提取节点(RegexExtract)
文件复制节点(FileCopy)
条件判断节点(IfElse)
开始节点(Start)
随机值节点(RandomValue)
大模型节点(LLM)
变量设置节点(Variable)
JS 执行器节点(JsRunner)
MCP 工具调用节点(McpToolsCall)
🔀 工作流使用说明
⚡ 功能节点
功能节点:视频片段删除/保留(VideoKeepPart)
功能节点:视频全局变速(VideoSpeed)
功能节点:视频添加音频(VideoMergeAudio)
功能节点:视频片段放大(VideoZoom)
功能节点:视频片段变速(VideoSpeedPart)
功能节点:视频尺寸转换(VideoSizeConvert)
功能节点:视频合并(VideoMerge)
功能节点:视频添加字幕(VideoSubtitle)
功能节点:视频压缩(VideoCompress)
功能节点:字幕转音频(SubtitleTts)
功能节点:智能剪辑(VideoQuickCut)
功能节点:图生图(ImageToImage)
功能节点:文生图(TextToImage)
功能节点:图生视频(ImageToVideo)
功能节点:文生视频(TextToVideo)
功能节点:视频标注(VideoMark)
功能节点:视频背景(VideoBackground)
功能节点:片头片尾图片(VideoMergeImage)
功能节点:声音归一化(AudioNormal)
功能节点:声音替换(SoundReplace)
功能节点:媒体格式转换(MediaFormatConvert)
功能节点:长文本转音频(LongTextTts)
功能节点:FFmpeg 处理(Ffmpeg)
🧠 模型介绍
CosyVoice3 3 秒零样本语音克隆大模型
IndexTTS2.5 多语言零样本语音克隆模型
SenseVoice 多语言高精度语音识别模型
VoxCPM 多语言高保真语音生成模型
Seed-VC 零样本歌声与语音转换模型
SadTalker 图片音频驱动的 3D 对口型说话视频生成模型
IndexTTS2 情感与时长可控的新一代语音合成模型
LivePortrait 人像图片驱动的面部动画生成模型
Wav2Lip 经典高精度语音驱动唇同步模型
CosyVoice 文本到语音模型
FishSpeech 语音合成模型
SparkTTS 基于大语言模型的语音合成模型
IndexTTS 工业级零样本语音克隆模型
LatentSync 端到端唇形同步模型
MuseTalk 实时高保真唇同步模型
FunAsr 语音识别模型
GPT-SoVITS 少样本声音复刻与语音合成模型
Heygem 离线数字人视频生成模型
👨💻 开发者中心
🧠 模型接入示例项目aigcpanel-server-demo
🧠 模型自定义接入-高级接入
🧠 模型自定义接入-简易接入
远程模型运行说明
远程模型 API 接口文档
❓ 模型接入常见问题
🧩 模型接入流程总览
📋 模型能力声明说明
🌐 远程模型使用进阶
🛠️ 工具
FFmpeg 处理
长文本转音频
视频背景
视频标注
声音替换
声音归一化
媒体格式转换
片头片尾图片
视频尺寸转换
视频合并
文生视频
图生视频
视频添加音频
视频添加字幕
视频全局变速
视频片段删除/保留
视频片段变速
视频片段放大
视频压缩
图生图
通用ComfyUI
通用模型
字幕转音频
智能剪辑
文生图
语音识别
🔀 工作流
⚡ 功能节点
功能节点:智能剪辑(VideoQuickCut)
功能节点:智能剪辑(VideoQuickCut)
更新时间: 2026-05-22 23:25:42
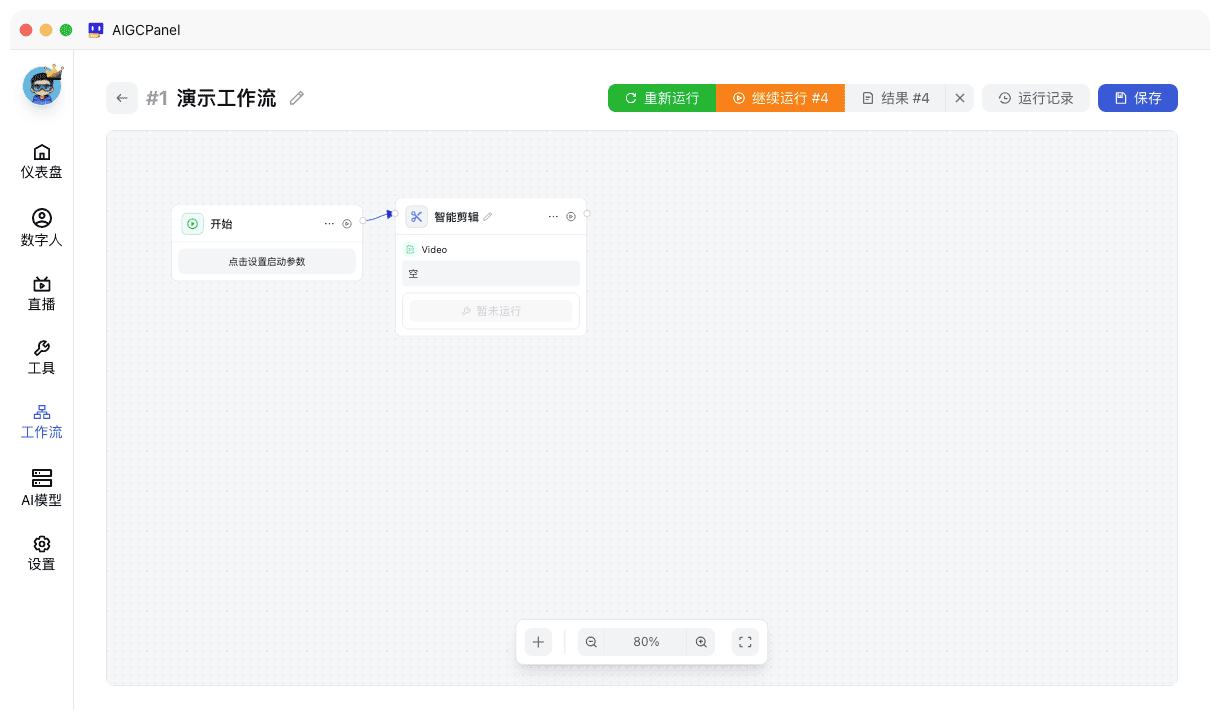
通过语音识别将视频内容转为文字片段,再根据片段选择自动剪辑视频。
输入字段
字段名
类型
说明
Video
文件(mp4)
需要剪辑的视频文件路径
输出字段
字段名
类型
说明
Video
文件(mp4)
剪辑后的视频文件路径
配置参数
参数
说明
语音识别服务(soundAsr)
选择已配置的语音识别模型
注意事项
需要提前在「服务器」页面配置语音识别模型
识别完成后进入人工确认步骤,可选择保留或删除各片段
识别准确率取决于音频质量,背景噪音较大时效果下降
语言
简体中文
English
QQ
QQ扫一扫联系
点击联系
2726531257
微信客服
微信扫一扫联系
微信群
微信扫一扫加群
客服