介绍
SenseVoice 是基于阿里巴巴达摩院 FunAudioLLM 项目中 SenseVoice-Small 架构的高精度多语言语音识别(ASR)模型,能够将语音内容准确转写为文字。它原生支持中文、粤语、英文、日文、韩文五种语言,覆盖了主流内容创作中最常见的语种,可直接用于字幕生成、会议记录、语音转写等任务。
除文字转写外,SenseVoice 还具备两项特色能力:内置情感识别,可判断语音中说话人的情绪倾向;音频事件检测,可识别笑声、掌声、背景音乐等非语音事件并输出标注。这意味着一次推理即可同时获得"转写文本 + 情感标签 + 环境事件标签",为内容分析、视频标注与智能剪辑提供更丰富的结构化信息。
SenseVoice 属于语音识别类模型,在 AIGCPanel 模型市场提供免费运行包,CPU 或 GPU 均可运行,对显卡没有强制要求,普通办公电脑即可部署使用。
主要功能
-
多语言语音识别:支持中文、粤语、英文、日文、韩文的高精度转写,中英混合场景表现良好。
-
情感识别:在转写文字的同时判断语音中的情感倾向,输出情绪标签。
-
音频事件检测:识别笑声、掌声、背景音乐等非语音事件并给出标注,辅助内容理解。
-
高效推理:模型轻量、识别速度快,适合长音频批量转写。
-
字幕生成:将转写结果直接整理为视频字幕,服务配音与后期流程。
-
本地化部署:数据不出本地即可完成转写,兼顾隐私与使用成本。
特点
-
语言覆盖全面:单模型同时支持五种常用语言及粤语,减少多语种切换成本。
-
输出信息丰富:文本、情感、音频事件三类信息一次获得,超越纯转写能力。
-
运行门槛低:CPU 或 GPU 均可运行,内存要求低,无需高端显卡。
-
识别精度高:基于 FunAudioLLM 架构,普通话与常见口音识别准确。
-
免费开源:模型免费使用,开源生态完善,社区持续维护。
应用场景
-
视频字幕生成:为口播、教程、访谈视频自动生成多语种字幕。
-
会议与访谈记录:将录音快速转写为文字,形成可检索的会议纪要。
-
内容审核与标注:结合情感与事件标签,批量分析视频音频中的情绪与关键声音。
-
无障碍语音转文字:为听障用户提供实时或离线的语音文字转换服务。
-
多语种本地化:识别中、英、日、韩等语言内容,为翻译与二次创作提供原始文本。
在 AIGCPanel 中的使用
- 前往 AIGCPanel 官方模型页面:SenseVoice 模型市场,下载一键运行包。
- 将下载的压缩包解压到纯英文路径下(避免中文路径导致环境加载失败)。
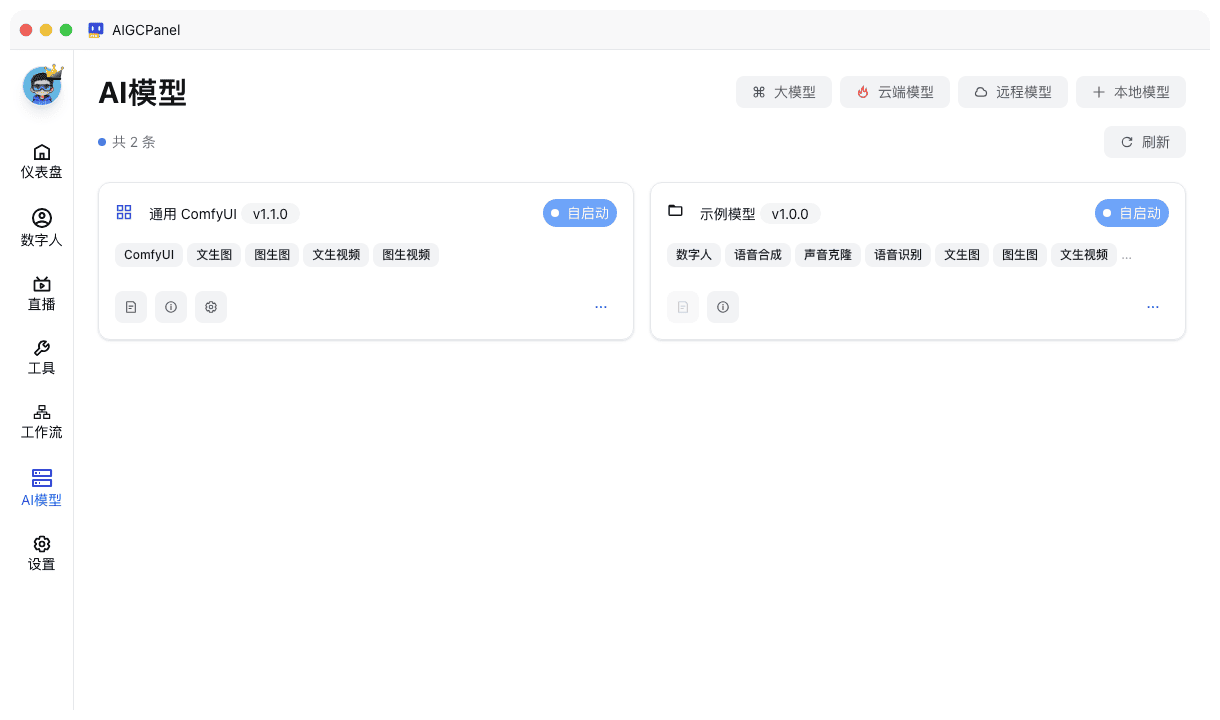
- 打开 AIGCPanel,在「AI模型」页面选择「添加本地模型」,指向解压后的模型目录并完成加载。
- 启动模型后,在「语音识别」等功能模块中选择 SenseVoice,上传音频或视频文件,生成文字转写结果。
硬件要求
| 项目 |
要求 |
| 显卡 GPU |
CPU 或 GPU 均可 |
| 内存 |
8G 及以上 |
| 费用 |
免费 |
开源信息
SenseVoice 基于阿里巴巴达摩院开源的 FunAudioLLM SenseVoice-Small,可在 AIGCPanel 模型市场直接下载运行包使用;同为阿里系的语音识别方案另见 FunAsr模型.md。