介绍
Seed-VC 是一款开源的零样本声音转换(Voice Conversion)模型,支持歌声转换与语音转换两大任务:输入一段源音频与一段目标音色参考音频,即可在保留原音频旋律、节奏与咬字的前提下,把声音"换"成目标音色。与传统需要微调训练的音色克隆方案不同,Seed-VC 无需针对目标说话人训练,参考音频取到即可转换。
在歌唱场景中,Seed-VC 引入 F0 音高条件,让模型显式感知源歌声的音高变化,并提供自动音高对齐能力,可自动处理源与目标之间的音域差异,避免转换后"跑调";在语音场景中,Seed-VC 支持实时语音转换,算法延迟约 300ms,可用于直播、连麦、在线会议等需要即时变声的场合。
Seed-VC 属于声音转换类模型,在 AIGCPanel 模型市场提供免费的一键运行包,支持 Windows 与 macOS 平台,下载解压后即可在本地运行。
主要功能
-
零样本语音转换:无需训练,用一段参考音频即可将源语音转换为目标音色。
-
歌声转换(SVC):保留原唱的旋律、节奏与唱法,仅替换音色,支持歌声场景。
-
F0 音高条件:显式利用基频信息建模,歌唱转换时音准跟随源音频更稳定。
-
自动音高对齐:自动处理音域不匹配问题,减少跨音域转换时的跑调现象。
-
实时语音转换:算法延迟约 300ms,支持低延迟的实时变声应用。
-
本地一键运行:打包环境由 AIGCPanel 模型市场分发,解压即可使用。
特点
-
零样本即用:目标音色只需参考音频,无需收集素材微调,切换音色成本低。
-
语音歌声双支持:一套模型同时覆盖说话与唱歌两类转换需求。
-
音准表现稳定:F0 条件与自动音高对齐保证歌唱内容不跑调、不失真。
-
低延迟实时能力:约 300ms 算法延迟,满足直播与会议等实时场景。
-
免费开源:开源权重可自由使用,社区持续更新维护。
应用场景
-
翻唱与二次创作:以任意音色重新演绎歌曲,快速产出翻唱作品。
-
虚拟歌手与音频制作:为原创 demo 替换目标歌手音色,辅助编曲与 Demo 演示。
-
直播与连麦变声:实时改变说话人音色,服务娱乐直播与匿名语音场景。
-
配音与有声内容:将旁白转换为目标角色音色,统一角色声音风格。
-
隐私保护通话:在会议或语音消息中隐藏真实音色,保护个人身份信息。
在 AIGCPanel 中的使用
- 前往 AIGCPanel 官方模型页面:Seed-VC 模型市场,下载对应平台的一键运行包。
- 将下载的压缩包解压到纯英文路径下(避免中文路径导致环境加载失败)。
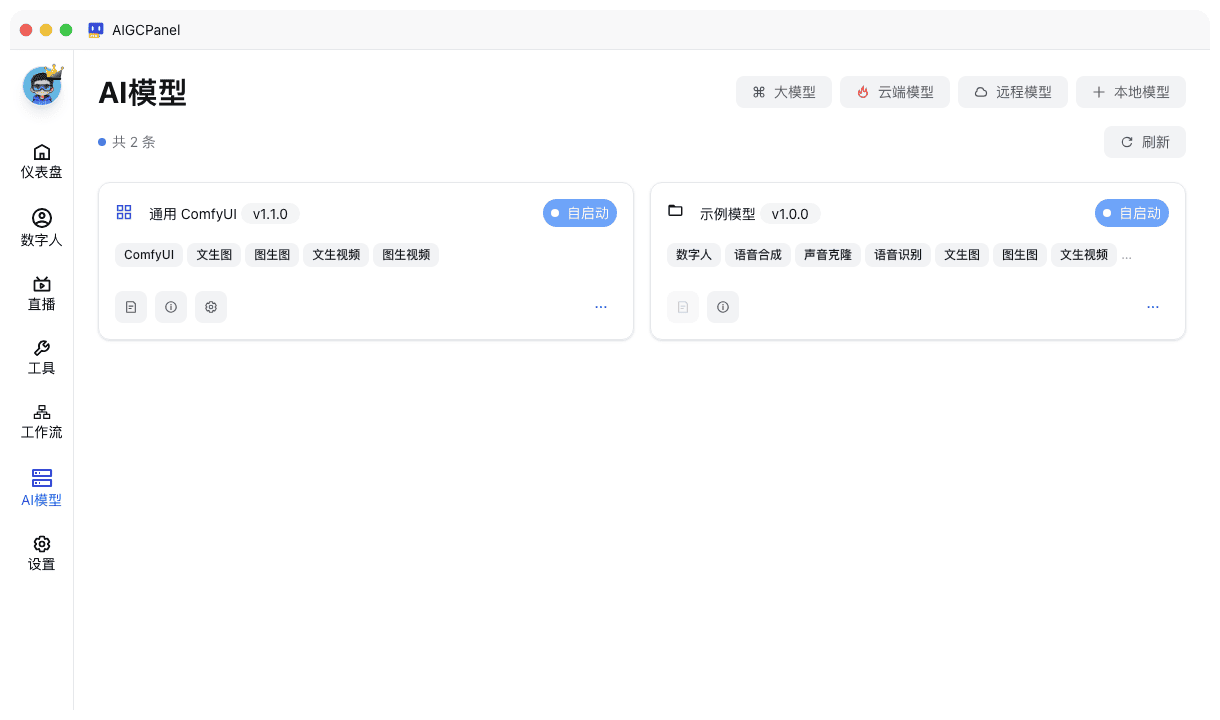
- 打开 AIGCPanel,在「AI模型」页面选择「添加本地模型」,指向解压后的模型目录并完成加载。
- 启动模型后,在「声音合成」等相关功能模块中选择 Seed-VC,上传源音频与目标音色参考音频,生成转换后的声音。
硬件要求
| 项目 |
要求 |
| 显卡 GPU |
8G 及以上 |
| 内存 |
16G 及以上 |
| 支持系统 |
Windows、macOS |
| 费用 |
免费 |
开源信息
Seed-VC 为开源零样本声音转换模型,可在 AIGCPanel 模型市场直接下载一键运行包使用;以文字生成语音的方案另见 CosyVoice3模型.md。