介绍
CosyVoice3 是阿里巴巴开源的第三代语音生成大模型,属于 FunAudioLLM 系列的最新力作。它延续了 CosyVoice 家族在零样本语音克隆上的优势,仅需约 3 秒参考音频即可复刻目标音色,同时在音质、情感韵律与多语言覆盖上进一步提升,生成语音在语调起伏、停顿呼吸等细节上更接近真人表达。
在能力层面,CosyVoice3 支持多种语言与中文方言的合成,能够处理带口音、带地域特色的语音内容;其情感与韵律建模细腻,可自然演绎疑问、感叹、喜悦等语气,避免传统 TTS 的机械感。此外,模型支持流式推理,输出延迟低,能够让语音在交互过程中"边生成边播放",满足实时性要求较高的场景。
CosyVoice3 属于语音合成类模型,在 AIGCPanel 模型市场提供免费的一键运行包,支持 Windows、macOS 与 Linux 平台,下载解压后即可在本地环境中使用。
主要功能
-
3 秒零样本语音克隆:仅需约 3 秒参考音频即可复刻音色,无需训练微调。
-
多语言多方言合成:支持中文、英文等多语言及中文方言内容的自然合成。
-
情感韵律表达:细腻还原语气、重音与节奏变化,生成语音富有情绪感染力。
-
流式低延迟输出:支持流式生成,边合成边播放,首包响应快、交互体验流畅。
-
文本到语音合成:输入任意文字即可生成发音清晰、语句连贯的高质量语音。
-
角色化多说话人合成:可在一句话或多轮对话中切换不同说话人音色。
特点
-
克隆门槛极低:3 秒样本即可完成音色复刻,素材获取成本几乎为零。
-
听感逼近真人:情感与韵律自然,弱化"机器味",可直接用于成品内容。
-
语言覆盖广:多语言与方言支持,适合普通话、方言及中英混说场景。
-
低延迟交互:流式推理能力使其可用于对话式、实时性应用。
-
免费开源:开源权重可自由使用,AIGCPanel 提供免费一键运行包。
应用场景
-
智能语音助手:为对话系统提供自然、有情绪反馈的实时语音应答。
-
有声读物与广播剧:多角色演绎文本内容,生成富有表现力的朗读与对白。
-
短视频与自媒体配音:快速生成个性化旁白,保持账号声音风格统一。
-
数字人与虚拟主播:作为数字人语音引擎,输出自然且低延迟的对白语音。
-
方言与本地化内容:生成带有地域口音特色的配音,增强内容亲和力。
在 AIGCPanel 中的使用
- 前往 AIGCPanel 官方模型页面:CosyVoice3 模型市场,下载对应平台的一键运行包。
- 将下载的压缩包解压到纯英文路径下(避免中文路径导致环境加载失败)。
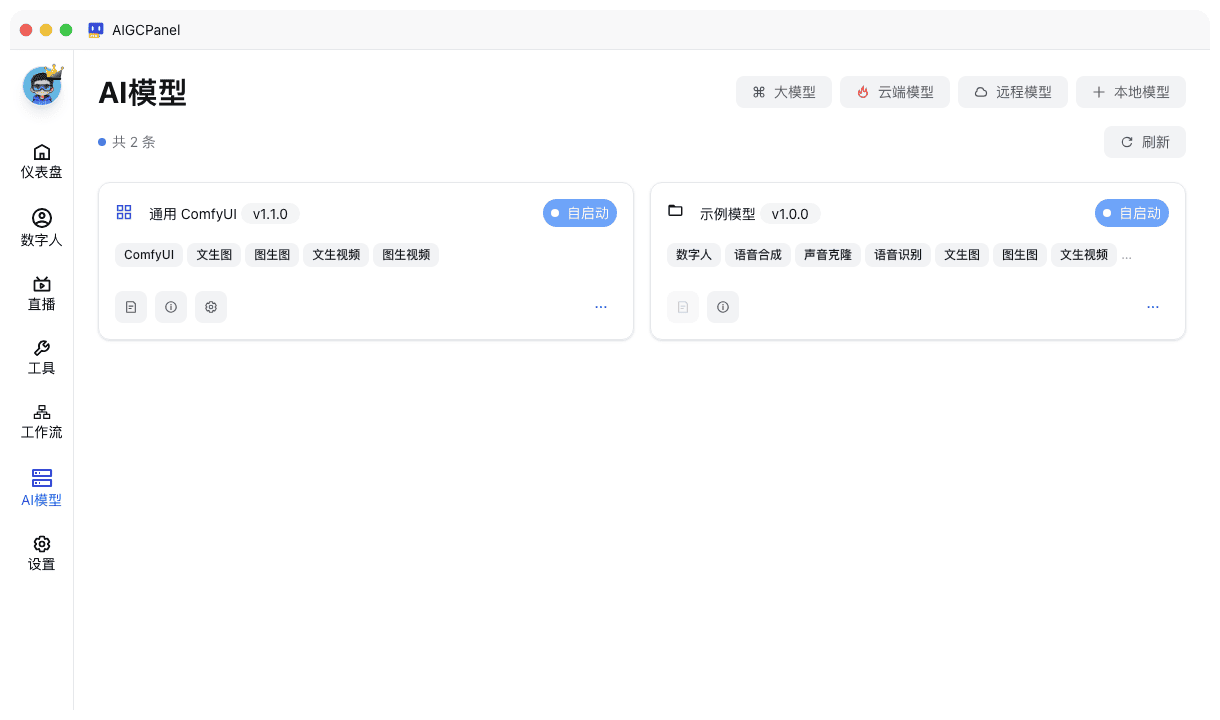
- 打开 AIGCPanel,在「AI模型」页面选择「添加本地模型」,指向解压后的模型目录并完成加载。
- 启动模型后,在「声音合成」等功能模块中选择 CosyVoice3,上传参考音频并输入文字,生成克隆语音。
硬件要求
| 项目 |
要求 |
| 显卡 GPU |
8G 及以上 |
| 内存 |
16G 及以上 |
| 支持系统 |
Windows、macOS、Linux |
| 费用 |
免费 |
开源信息
CosyVoice3 由阿里巴巴(达摩院 FunAudioLLM 团队)开源,可在 AIGCPanel 模型市场直接下载一键运行包使用;上一代方案见 CosyVoice模型.md。