介绍
SadTalker 是基于 CVPR 2023 论文《SadTalker: Learning 3D Motion Conditions for 3D Talking Head Generation》的开源对口型说话视频生成模型。它以人物静态照片与一段音频作为输入,生成头部运动自然、口型与语音精确同步的说话视频,是"照片开口说话"这一经典任务中的代表性方案。
与仅在原图上做 2D 变形的早期方案不同,SadTalker 从音频中学习三维运动条件,先估计出合理的三维头部姿态与面部表情,再将其渲染为视频。因此生成结果中的头部摆动、表情变化与嘴部开合协调统一,人物身份保持良好,避免了脸部扭曲、贴图抖动等常见问题,整体观感更加真实稳定。
SadTalker 属于视频合成类模型,在 AIGCPanel 模型市场提供免费的一键运行包,支持 Windows(x86)与 macOS(Apple 芯片)平台,下载解压后即可在本地生成对口型视频。
主要功能
- 照片说话视频生成:输入人物图片与音频,生成口型与语音同步的说话视频。
- 3D 运动驱动:从音频估计三维头部姿态与表情,头部运动协调自然。
- 音画精确同步:嘴型开合与发音逐帧对齐,口型准确、不吞字不跳帧。
- 人脸身份保持:生成视频中的人物样貌与原始照片保持一致,不易失真。
- 单图即可生成:无需多张照片或视频素材,一张正面人像即可完成制作。
- 本地一键运行:打包环境随 AIGCPanel 模型市场分发,解压即可使用。
特点
- 真实感强:三维运动条件建模带来自然的头部与表情变化,弱化"贴脸动画"感。
- 稳定性高:长时间音频生成画面不易抖动,人物形象保持一致。
- 素材要求低:只需一张图片加一段音频,内容生产成本低。
- 跨平台支持:兼容 Windows(x86)与 macOS(Apple 芯片)。
- 免费开源:CVPR 2023 开源方案,权重与代码公开,可免费使用。
应用场景
- 数字人播报:让静态人物照片开口朗读文稿,快速制作新闻与知识类口播视频。
- 历史人物与虚拟形象:驱动肖像照片"讲述"内容,用于博物馆、科普与文创场景。
- 短视频个性化内容:为头像、卡通形象配音并生成说话画面,提升内容表现力。
- 在线教育与培训:将课程讲义转为讲师头像讲解视频,降低拍摄成本。
- 社交与创意玩法:用一张照片配上任意语音,制作趣味对口型视频。
在 AIGCPanel 中的使用
- 前往 AIGCPanel 官方模型页面:SadTalker 模型市场,下载对应平台的一键运行包。
- 将下载的压缩包解压到纯英文路径下(避免中文路径导致环境加载失败)。
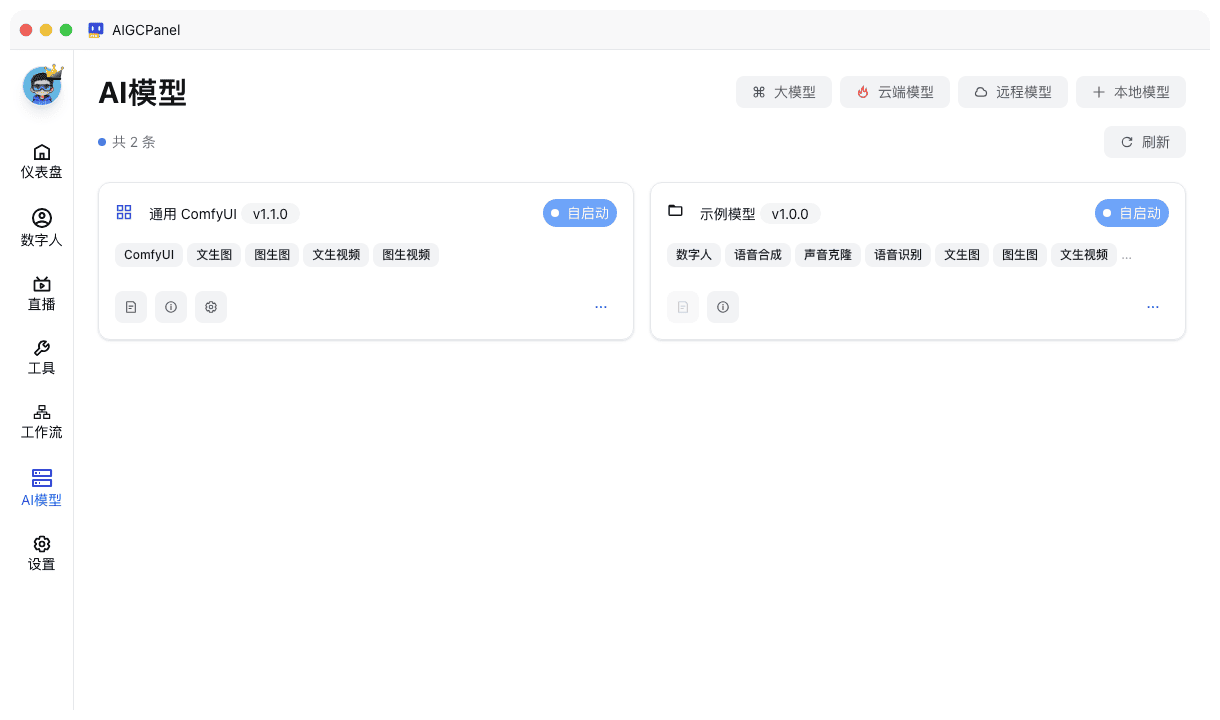
- 打开 AIGCPanel,在「AI模型」页面选择「添加本地模型」,指向解压后的模型目录并完成加载。
- 启动模型后,在「视频合成」等功能模块中选择 SadTalker,上传人物图片与驱动音频,生成对口型说话视频。
硬件要求
| 项目 | 要求 |
|---|
| 显卡 GPU | 4G 及以上 |
| 内存 | 8G 及以上 |
| 支持系统 | Windows(x86)、macOS(Apple 芯片) |
| 费用 | 免费 |
开源信息
SadTalker 基于 CVPR 2023 开源研究工作,可在 AIGCPanel 模型市场直接下载一键运行包使用;其他口型同步方案另见 Wav2Lip模型.md 与 LatentSync模型.md。