介绍
Wav2Lip 是一款经典且广受认可的高精度语音驱动唇同步(Lip Sync)模型,最初由 IIT Kharagpur 的研究团队提出。它能够将任意视频中人物的唇形与任意目标语音进行精确同步,生成口型自然、与语音高度匹配的说话画面。Wav2Lip 最大的优势在于其"通用性":适用于任意身份(不同人脸、不同肤色)、任意语音(不同内容、不同音色)与任意语言,无需针对特定人物或语种进行单独训练。
在技术原理上,Wav2Lip 采用基于唇部区域识别与生成的深度学习框架,通过提取视频帧中的面部区域,结合音频的声学特征,训练一个能够精准判断"口型是否与语音匹配"的判别机制,并据此驱动嘴部区域的重建生成。这种设计使模型在极宽泛的输入条件下(包括低分辨率、不同光照、不同姿态的视频)仍能保持稳定的同步效果,因此成为唇同步领域被引用与使用最多的开源基线模型之一。
Wav2Lip 定位于通用的视频口型驱动与修复,广泛应用于视频配音修正、虚拟形象驱动、跨语言口型适配等场景。它在 AIGCPanel 模型市场提供免费一键运行包(含 384 优化版),支持 Windows(x86)平台,硬件要求低(GPU 4G 及以上即可运行),是入门与快速验证唇同步效果的性价比之选。
主要功能
- 任意身份唇同步:无需针对特定人脸训练,支持不同人物、不同视频素材的口型驱动。
- 任意语音驱动:支持任意内容、任意音色的目标语音,口型与发音精确对齐。
- 多语言支持:兼容不同语种的语音输入,可驱动对应语言的口型变化。
- 高精度同步:口型与语音匹配度高,生成的说话效果自然真实。
- 视频配音修复:为口型与语音不匹配的已有视频重新对齐唇形,修正画面。
- 多种精度版本:提供标准版与 384 优化版,适配不同画质与硬件条件的需求。
特点
- 通用性强:任意身份、任意语音、任意语言均可驱动,适用范围极广。
- 同步精度高:以精确的口型匹配著称,是业界公认的高精度唇同步基线。
- 硬件门槛低:GPU 4G、内存 8G 即可运行,消费级设备即可部署使用。
- 成熟稳定:作为经典开源模型,社区积累深厚,使用资料与经验丰富。
- 易用灵活:输入输出形式简单(视频 + 语音 → 视频),便于集成到各类工作流。
应用场景
- 视频后期配音修正:修复已拍摄视频中口型与替换语音不匹配的问题,省去重拍。
- 跨语言视频本地化:将视频对白替换为其他语言后重新驱动口型,适配目标语种观众。
- 虚拟人与数字人驱动:为虚拟形象 / 数字人注入任意语音,实现开口说话效果。
- 短视频与自媒体创作:快速生成与配音对齐的口型画面,提升内容观感。
- 影视与广告制作:在补拍困难或对白调整场景中,用口型同步技术完成画面修正。
- 无障碍与娱乐应用:为语音驱动的互动内容、表情包、趣味视频提供口型动画。
在 AIGCPanel 中的使用
- 前往 AIGCPanel 官方模型市场页面:Wav2Lip 模型市场,下载对应平台的一键运行包(含 384 优化版可选)。
- 将下载的压缩包解压到纯英文路径下,确保模型与依赖正常加载。
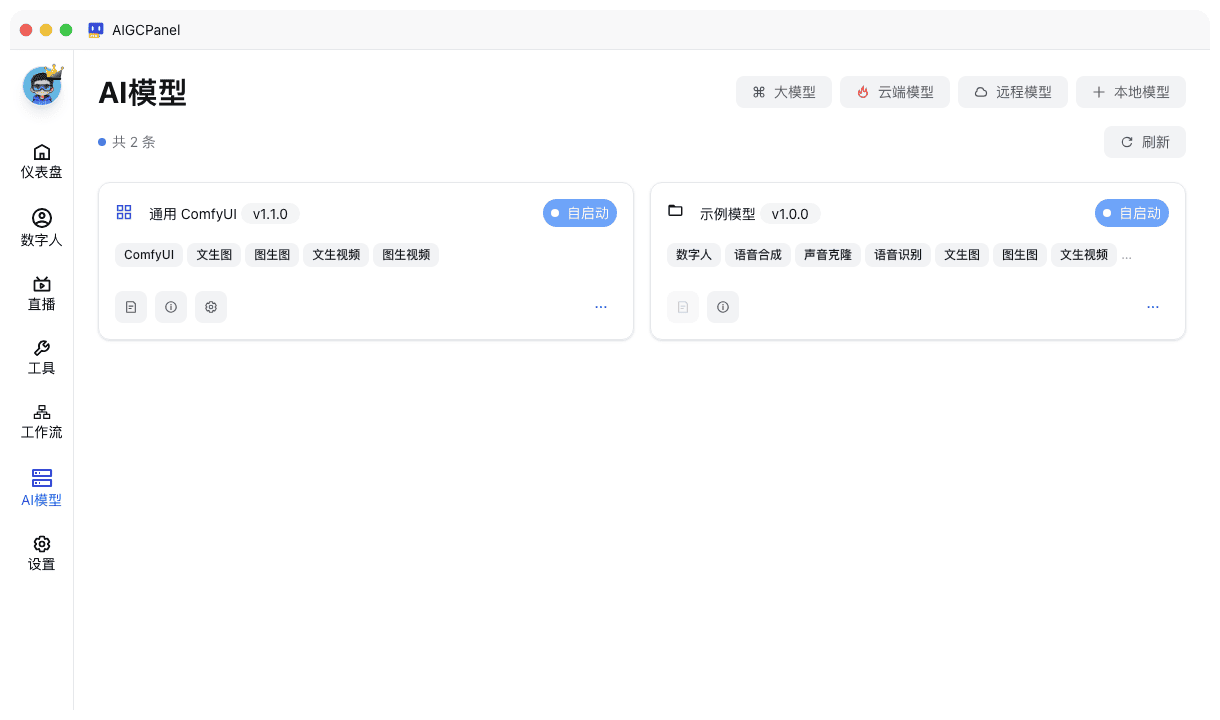
- 打开 AIGCPanel,在「AI模型」页面选择「添加本地模型」,指向解压后的模型目录并完成加载。
- 启动模型后,在「视频合成」等功能模块中选择 Wav2Lip,上传待处理视频与目标语音,生成唇同步视频。
硬件要求
| 项目 | 要求 |
|---|
| 显卡 GPU | 4G 及以上 |
| 内存 | 8G 及以上 |
| 支持系统 | Windows(x86)(另有 384 优化版) |
| 费用 | 免费 |
GitHub 链接
Wav2Lip GitHub