介绍
MuseTalk 是由腾讯音乐(TMElyralab)开源的一款实时、高保真唇同步(Lip Sync)模型,专注于根据输入音频实时调整视频中人物的唇形,实现与语音精确同步的说话效果。不同于逐帧离线处理的传统方案,MuseTalk 在设计上高度优化了推理效率,在 NVIDIA V100 等显卡上可达 30fps 以上的实时推理速度,使"边输入语音、边生成口型"的交互式应用成为可能。
在技术层面,MuseTalk 采用非自回归(Non-autoregressive)的生成框架,将人脸区域检测、嘴部区域生成与帧间协调相结合,避免了自回归模型逐帧串行计算的效率瓶颈,从而实现高帧率的稳定输出。模型在训练中以真实人脸数据为基础,注重嘴部区域的细节还原与自然度,合成结果在保持高保真画质的同时,唇形与发音保持高度一致。此外,MuseTalk 支持多语言语音输入,中文、英文等不同语言的音频均可正确驱动口型。
MuseTalk 定位于实时视频配音与唇同步场景,是数字人直播、实时互动、视频批处理等应用的理想选择。它在 AIGCPanel 模型市场提供免费一键运行包,支持 Windows、macOS 与 Linux 平台,硬件门槛较低(GPU 6G 及以上即可运行),易于在消费级显卡设备上部署。
主要功能
- 实时唇同步:根据输入音频实时驱动视频中人物的唇形,V100 上可达 30fps 以上的推理速度。
- 高保真唇形生成:精细还原嘴部区域细节,合成结果自然清晰,观感真实。
- 多语言支持:支持中文、英文等多种语言的音频驱动,适配不同语种内容。
- 非自回归高效推理:采用非自回归框架,摆脱逐帧串行计算限制,处理速度大幅提升。
- 通用人脸适配:支持不同人物、不同视频素材的唇形驱动,无需针对个体单独训练。
- 帧间协调稳定:注重视频帧之间的连贯性,长片段合成不易出现闪烁或跳变。
特点
- 实时性能强:30fps+ 的推理速度,支持实时与近实时的视频处理应用。
- 同步效果精准:唇形与语音发音精确匹配,说话动作自然流畅。
- 画质高保真:生成的嘴部区域细节丰富,与原始视频风格自然融合。
- 硬件门槛低:GPU 6G 及以上即可运行,消费级显卡设备即可部署。
- 跨平台支持:兼容 Windows、macOS、Linux 系统,部署灵活。
应用场景
- 数字人直播与实时互动:实时驱动数字人口型,支撑直播、虚拟陪伴等交互场景。
- 视频配音与后期处理:为已有视频替换语音后快速重新对齐口型,提升制作效率。
- 短视频与自媒体创作:批量为口播视频生成与语音匹配的说话画面。
- 在线教育与培训:为教学视频生成讲解人口型,让课程表达更生动专业。
- 影视与游戏内容制作:在多语言版本或补拍场景中快速生成对齐口型的画面。
- 虚拟客服与助手:为具备形象的虚拟客服驱动口型,增强交互真实感。
在 AIGCPanel 中的使用
- 前往 AIGCPanel 官方模型市场页面:MuseTalk 模型市场,下载对应平台的一键运行包。
- 将下载的压缩包解压到纯英文路径下,确保模型与依赖正常加载。
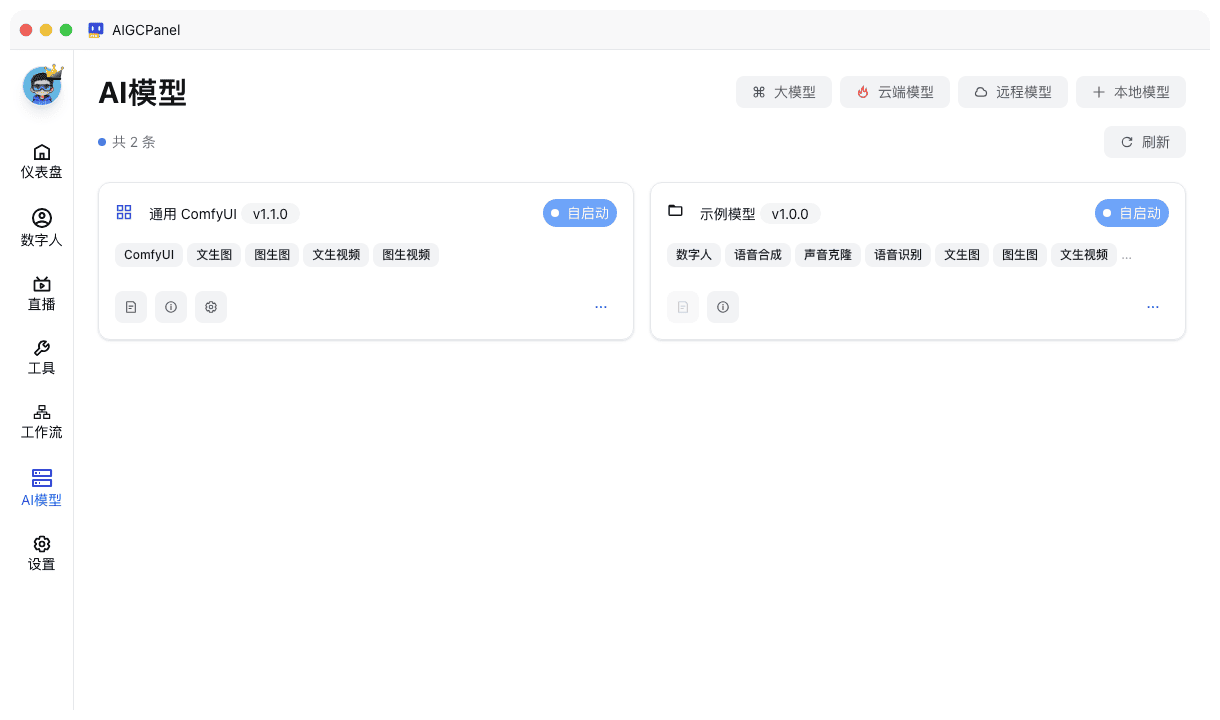
- 打开 AIGCPanel,在「AI模型」页面选择「添加本地模型」,指向解压后的模型目录并完成加载。
- 启动模型后,在「视频合成」等功能模块中选择 MuseTalk,上传视频与目标语音,生成实时唇同步视频。
硬件要求
| 项目 | 要求 |
|---|
| 显卡 GPU | 6G 及以上 |
| 内存 | 16G 及以上 |
| 支持系统 | Windows、macOS、Linux |
| 费用 | 免费 |
GitHub 链接
MuseTalk GitHub