介绍
SparkTTS 是由 SparkAudio 开源的一款基于大语言模型(LLM)的语音合成(TTS)系统,它将大语言模型强大的语义理解与序列建模能力引入语音生成领域,实现了高质量、高可控性的文本到语音转换。与传统 TTS 系统不同,SparkTTS 利用 LLM 作为核心建模引擎,将语音属性(如性别、音调、语速等)以离散化语音单元的形式纳入序列建模过程,使模型在生成语音的同时,能够对语音风格进行精细、直观的控制。
在技术架构上,SparkTTS 通常包含两个核心部分:基于 Qwen 等大语言模型的语音生成主干,以及配套的音频编解码模块。LLM 负责将文本与风格指令解码为语音离散单元序列,编解码模块则负责将这些单元还原为高质量的连续音频波形。这种设计带来了两大优势:其一,零样本语音克隆能力——只需参考音频即可模仿任意说话人音色;其二,虚拟说话人生成能力——在没有参考音频的情况下,通过文本描述或参数指令即可创造全新的、可控的声音角色。
SparkTTS 支持对性别、音调、语速等多种语音属性进行灵活调整,让用户无需训练即可定制化地"设计"声音。它在 AIGCPanel 模型市场提供免费一键运行包,支持 Windows(x86)与 macOS(Apple 芯片)平台,适合语音应用开发、内容创作与研究探索等多种用途。
主要功能
- 文本到语音合成:将输入文字转换为高质量、自然流畅的合成语音。
- 零样本语音克隆:无需训练,仅凭参考音频即可复刻目标说话人的音色与风格。
- 虚拟说话人生成:在无参考音频时,通过指令或参数创造全新的可控声音角色。
- 属性精细控制:支持调整性别、音调、语速等语音属性,直观定制声音效果。
- 多语言支持:兼容中英文等多语言内容的合成,适应跨语言应用需求。
- LLM 驱动建模:以大语言模型为核心引擎,充分利用其语义理解提升韵律自然度。
特点
- 大模型驱动:基于 LLM 的序列建模让语音生成更理解文本语义,韵律表达自然。
- 零样本能力强:无需目标说话人训练数据,参考音频即可完成高质量克隆。
- 可控性出色:性别、音调、语速等属性可灵活调节,声音定制自由度高。
- 克隆与创声兼备:既能复刻既有声音,也能生成全新的虚拟说话人,应用面广。
- 开源生态:代码与模型开源,社区活跃,便于研究、集成与二次开发。
应用场景
- 语音助手与导航:为智能助手、车载导航提供自然且风格可控的语音播报。
- 有声读物与播客:快速生成多角色、多风格的朗读音频,提升内容生产效率。
- 广告与视频配音:为广告、短视频生成定制化旁白声音,匹配品牌调性。
- 游戏与动画配音:为游戏角色创造独特音色,实现零样本的多角色配音。
- 语言学习与教育:生成标准发音与多语种教学音频,辅助语言学习。
- 研究与原型开发:作为 LLM-based TTS 的研究基线,支撑语音技术探索。
在 AIGCPanel 中的使用
- 前往 AIGCPanel 官方模型市场页面:SparkTTS 模型市场,下载对应平台的一键运行包。
- 将下载的压缩包解压到纯英文路径下,确保模型与依赖正常加载。
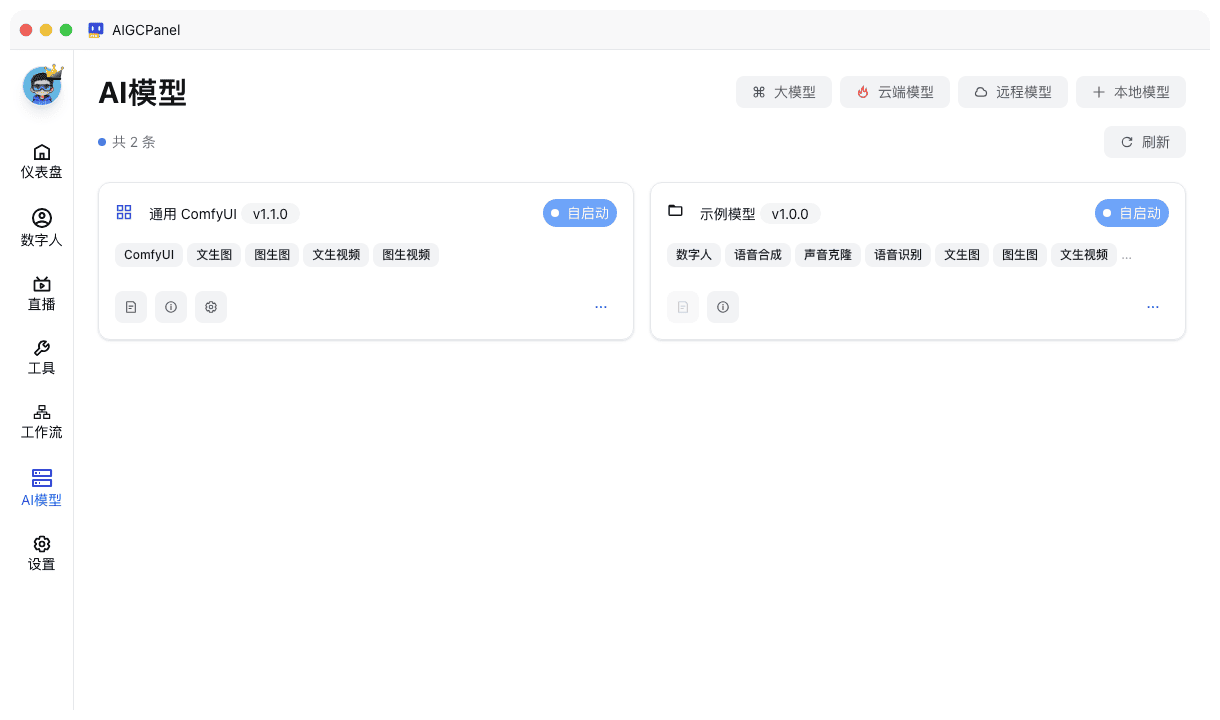
- 打开 AIGCPanel,在「AI模型」页面选择「添加本地模型」,指向解压后的模型目录并完成加载。
- 启动模型后,在「声音合成」等功能模块中选择 SparkTTS,输入文字并按需上传参考音频,生成定制化语音。
硬件要求
| 项目 | 要求 |
|---|
| 显卡 GPU | 8G 及以上 |
| 内存 | 16G 及以上 |
| 支持系统 | Windows(x86)、macOS(Apple 芯片) |
| 费用 | 免费 |
GitHub 链接
SparkTTS GitHub