语音识别(ASR)功能可以将视频或音频中的语音内容自动转录为带时间轴的文字,常用于生成字幕、整理访谈记录、为智能剪辑提供文本依据。
1. 选择功能入口
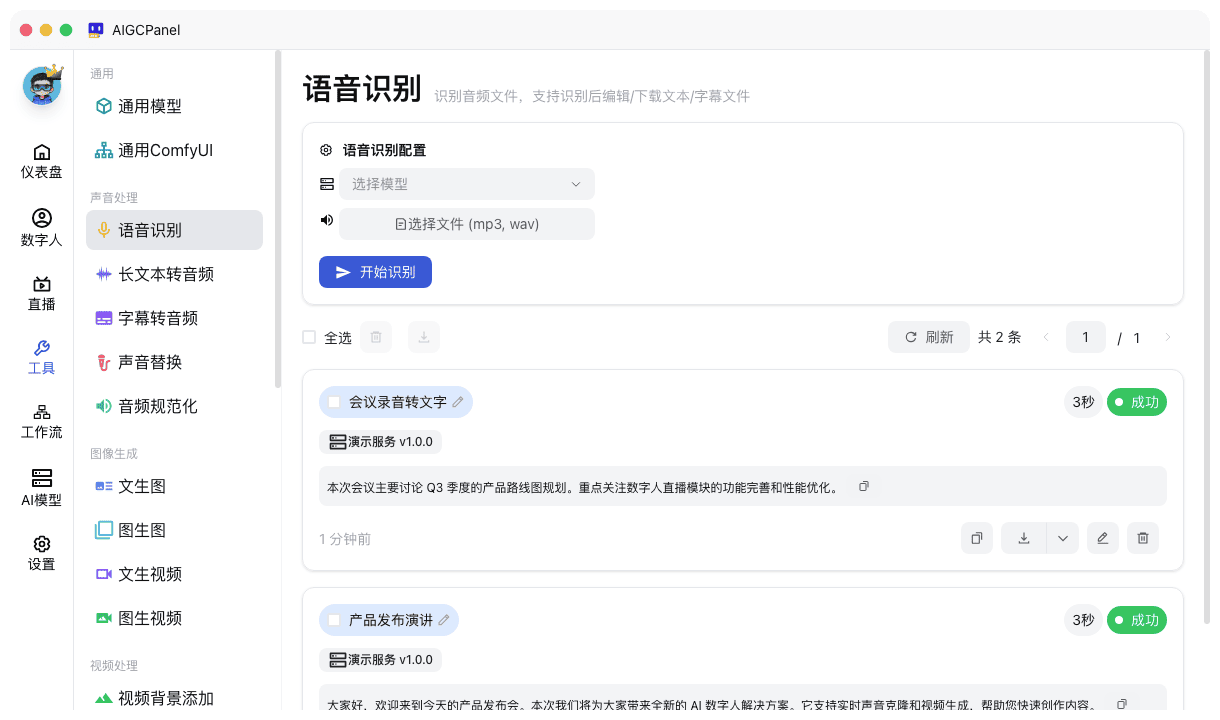
打开软件,点击左侧导航栏「工具」,在声音处理分组中选择「语音识别」。
也可以在工作流中通过「功能调用」加载语音识别节点,实现批量自动识别。
2. 上传音频文件
点击「选择文件」,上传需要识别的音频或视频文件:
- 支持 MP3、WAV 等音频格式
- 也支持直接上传 MP4 等视频文件,自动提取音轨识别
3. 选择语音识别模型
在模型下拉框中选择已配置的语音识别模型,支持本地模型与云端模型:
- 本地模型:如 FunASR,需提前在「AI模型」页添加并启动(状态为绿色运行中)
- 云端模型:无显卡也可使用,按使用量计费
如果没有可用模型,请先前往「AI模型」页面添加并启动语音识别模型,或开通 云模型。
4. 点击开始识别
点击「开始识别」,等待任务完成。识别时长与音频长度、电脑配置相关,请耐心等待。

5. 查看与导出结果
识别完成后,可查看带时间轴的文字结果:
- 编辑文字 — 在结果区域直接修改识别错误的内容
- 导出字幕 — 支持导出为 SRT 字幕文件,便于后续添加到视频
- 下载结果 — 保存识别文本,支持批量选择多条记录进行删除或下载
常见问题
- 识别准确率低 — 识别效果取决于音频质量,背景噪音较大时准确率会降低,建议使用清晰、低噪音的音频
- 多人说话能否区分 — FunASR 支持说话人分离能力,可区分不同发言人
- 导出的字幕如何烧录进视频 — 可使用「工具」中的「视频添加字幕」功能,将 SRT 字幕嵌入视频画面
相关功能
- 声音替换 — 识别视频原声并用指定音色重新合成替换
- 智能剪辑 — 通过语音识别快速选择片段进行剪辑
- 视频添加字幕 — 将 SRT 字幕文件嵌入视频画面
- 字幕转音频 — 根据 SRT 字幕按时间轴合成音频