图:音频进,文字和字幕出
把 mp3、wav 里的说话声转成带时间戳的文字,结果能直接导出 txt 或 srt。给数字人准备文案、给视频配字幕、核对录音内容都用它。
什么时候用
- 适合:一段人声录音要变成文字稿;视频要配字幕,但手上只有音轨
- 不适合:直接扔视频文件进来,这个工具只认 mp3 和 wav,先用 FFmpeg 处理 的「提取音频」模板把音轨抽出来
- 不适合:多说话人会议要分角色,识别结果不分轨,只有一句一行的时间和文本
操作步骤
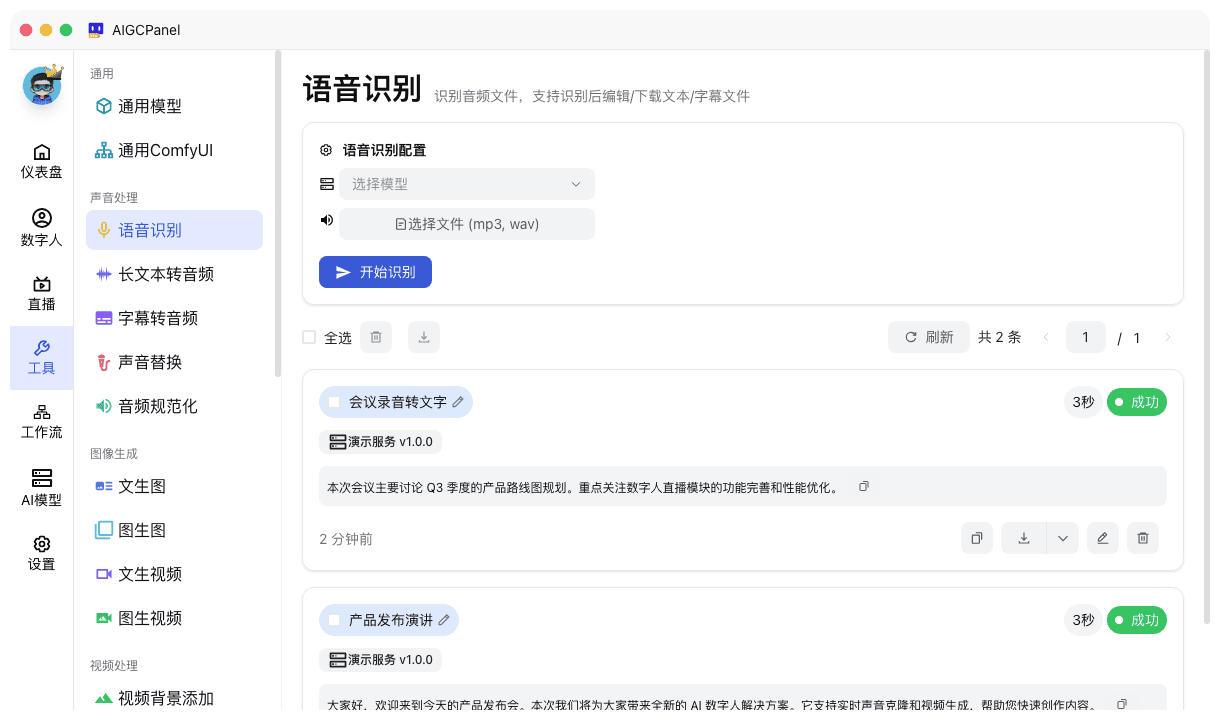
- 工具 → 声音处理 → 语音识别(第一次打开工具页就是这一页)
- 选择模型,下拉里是这个已经启动的语音识别服务
- 选择文件,只列 mp3 和 wav
- 点「开始识别」,弹出「语音识别任务已提交」
- 任务卡片出现「成功」后,在文本区看结果,可以复制、编辑、下载
参数
| 参数 | 说明 | 建议 |
|---|
| 选择模型 | 语音识别服务,未启动的模型不出现 | 走 FunASR,先看 AI模型 里是否运行中 |
| 选择文件 | 音频路径,支持 mp3、wav | 16kHz 以上、单人说话的干声 |
| 模型参数 | 由模型 config.json 声明,例如采样率、语言 | 默认值能跑通就别改 |
结果与排查
- 成功表现:卡片上有绿色「成功」、耗时、模型名;文本区出现整段文字;下载按钮有两个选项
- 结果怎么用:右上角图标依次是复制文本、下载(文本文件 .txt / 字幕文件 .srt)、编辑识别结果、删除。编辑是逐句改,保存后回写到任务结果,再下载就是改过的内容
- 报「所选音频文件不存在,请重新选择」:文件被移动或删了,重新选一次
- 报「语音识别模型未启动」:去 AI模型 页把识别模型启动,等状态变成运行中再回来
- 识别出来是空的:音频里没人声,或者音量太低。先听一遍原文件
- 字幕文件时间轴是识别出来的时间,不是原视频的时间,配音前对一下
相关