QQ扫一扫联系
同一段文本,参数不同结果差异很大。本文说明声音合成常见参数的含义与调节建议,并对比不同模型方向的音色差异。
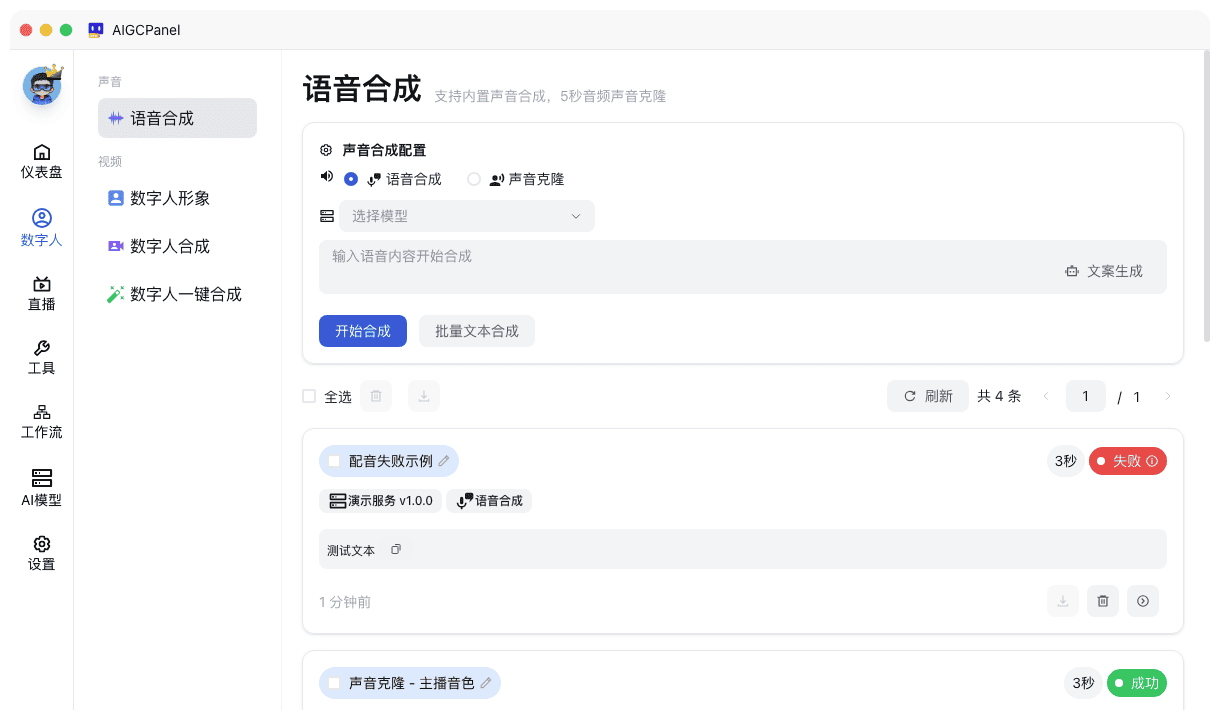
💡 具体可用参数由所选模型声明决定,界面实际显示的参数项以当前模型为准。
| 参数 | 含义 | 调节建议 |
|---|---|---|
| 音色 / 发音人 | 决定声音的性别、音质与风格 | 先逐个试听,选择与内容匹配的音色 |
| 语速(speed) | 播报快慢,1x 为原速 | 常用 0.9~1.1 之间微调;促销内容可略快 |
| 音调 | 声音高低 | 小幅调整即可,幅度过大易失真、变“机器音” |
| 音量 | 输出响度 | 保持中等,避免过载爆音;后期可用声音归一化统一 |
| 参考音频 | 声音复刻时提供目标音色 | 选择清晰、无噪音、时长达标的音频 |
| 参考文字 | 部分模型要求填写的参考音频全文 | 与参考音频内容逐字保持一致 |
| 模型方向 | 特点 | 适用场景 |
|---|---|---|
| CosyVoice | 音色丰富,支持中英等多语言与声音复刻 | 通用配音、多语种内容 |
| IndexTTS | 零样本复刻自然度高,韵律与停顿自然 | 专属音色、长内容播报 |
| GPT-SoVITS | 少样本复刻,风格迁移能力强 | 需要还原个人说话风格 |
| 云端音色 | 无需本地显卡,内置多款可在线试听 | 无显卡设备、快速出活 |